Talleres de Primavera, Universidad Alberto Hurtado, 14 de noviembre de 2026
¿La IA ve las mismas ilusiones que tú?
Percepción humana, percepción artificial y qué significa ver
Alfredo Muñoz Alarcón, Doctorado en Filosofía UAH.
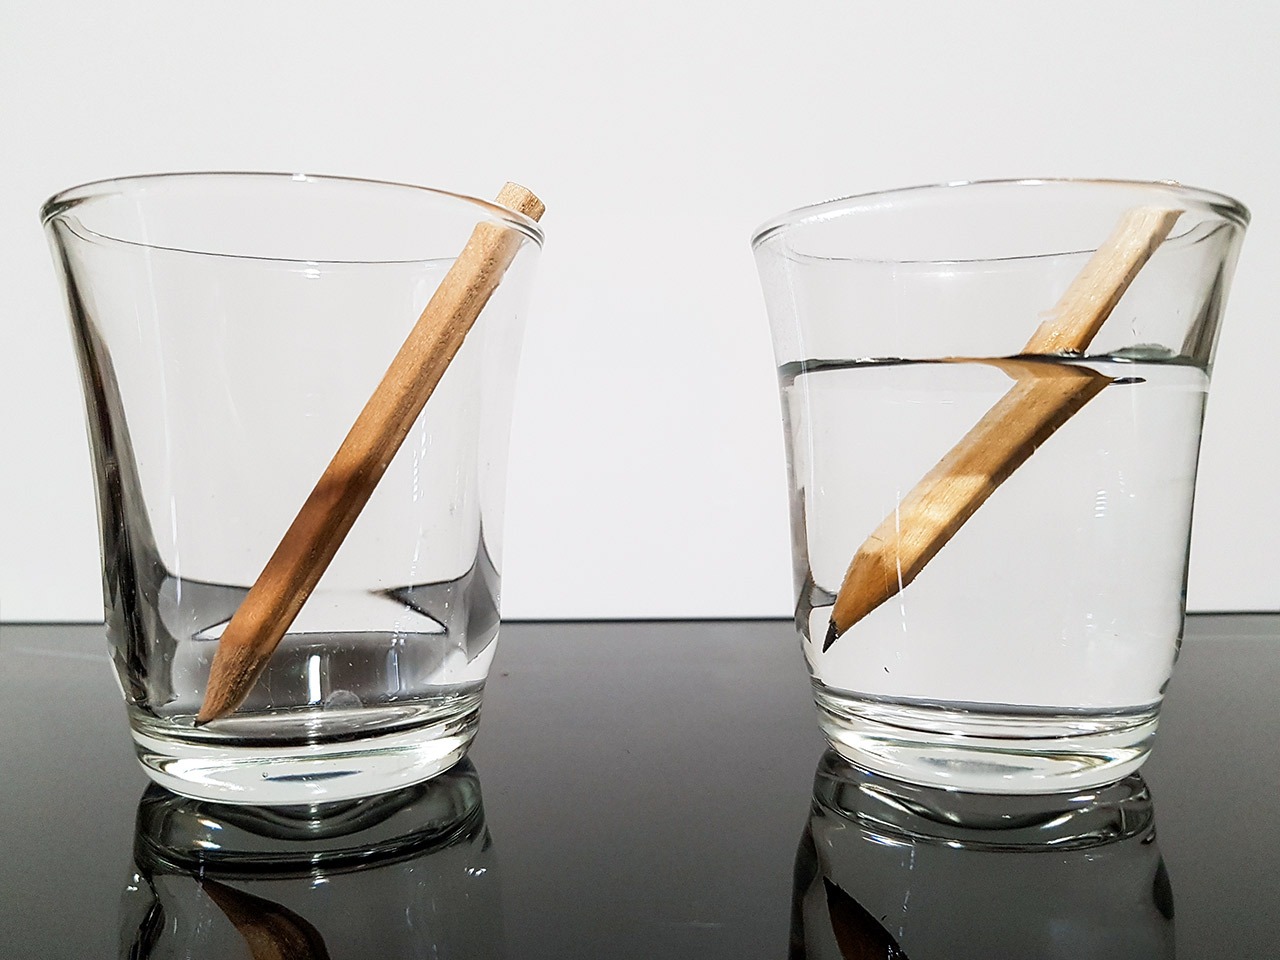
Un lápiz en un vaso vacío y otro en un vaso con agua. ¿Cuál está quebrado?
Foto: dzoom (dzoom.org.es), licencia CC BY.
El mismo vaso de agua
Dos mil años mirando un palo en el agua
Atenas, hacia 375 a. C.
Platón
“El mismo objeto se ve derecho cuando se lo mira fuera del agua, y torcido cuando está dentro.”
Los sentidos nos confunden. Nos rescata medir y calcular.
París, 1641
Descartes
Le objetan: “Un bastón parece quebrado en el agua a causa de la refracción: ¿quién corregirá ese error?”. Responde: “Es sólo el entendimiento el que corrige el error del sentido.”
Ni la vista ni el tacto se corrigen solos: corrige la razón.
Publicado en 1962
J. L. Austin
“¿Qué tiene de sorprendente que un palo sea derecho y a veces se vea torcido?”
No hay engaño: así se ve un palo derecho en el agua.
Platón, “República” X, 602c (desde la versión inglesa de Jowett). Descartes, Sextas Objeciones y Respuestas, punto 9 (desde el francés). Austin, “Sense and Sensibilia”, p. 29 (abreviada). Traducciones propias.
Quién soy
Alfredo Muñoz
Doctorado en Filosofía, Universidad Alberto Hurtado. Estudio ilusiones que no se van aunque uno sepa la verdad.
Hoy: ver varias, preguntarnos por qué pasan y mostrárselas a la inteligencia artificial.
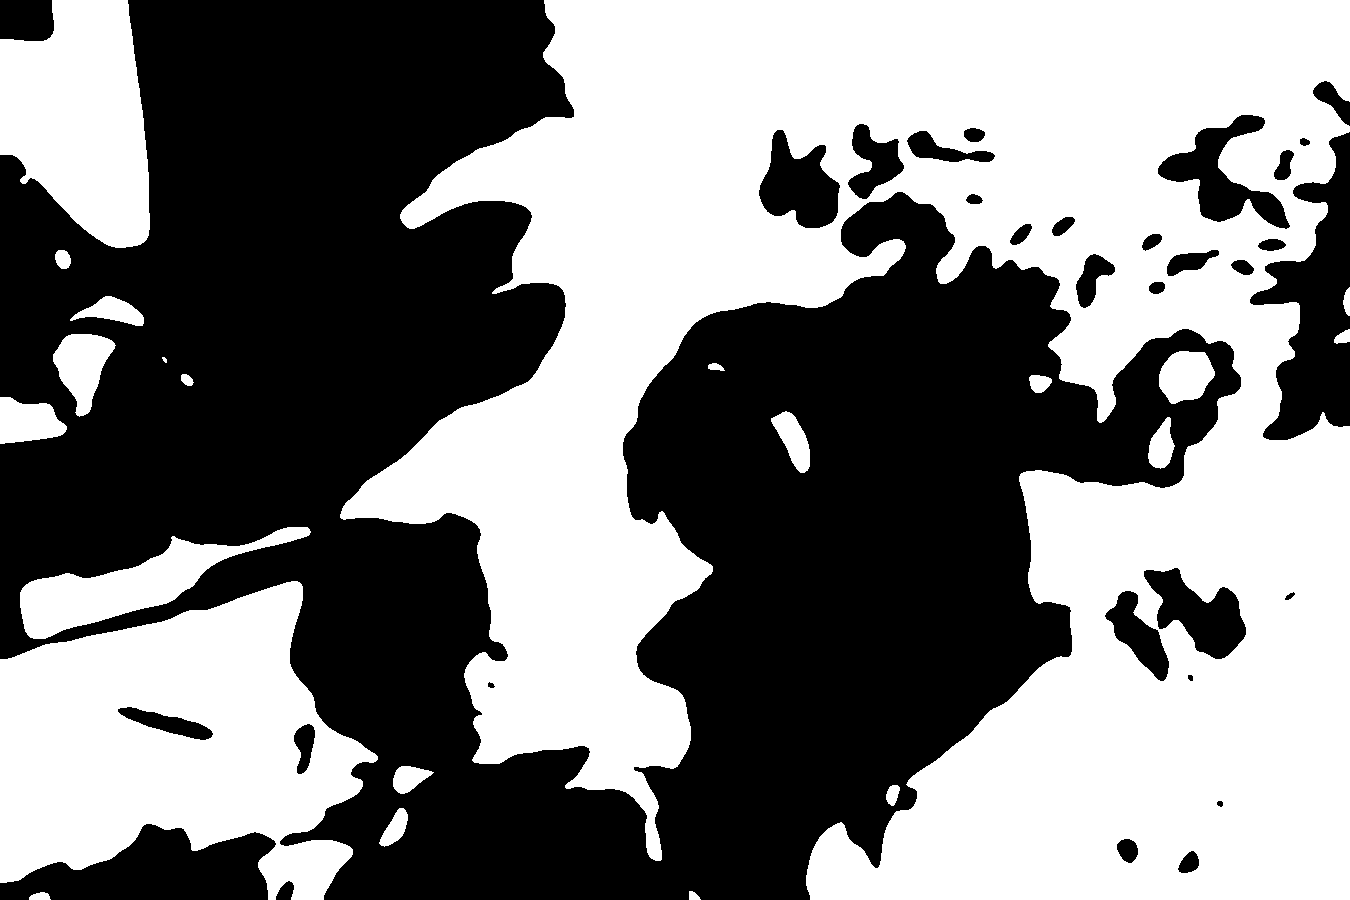
¿Qué ven aquí?
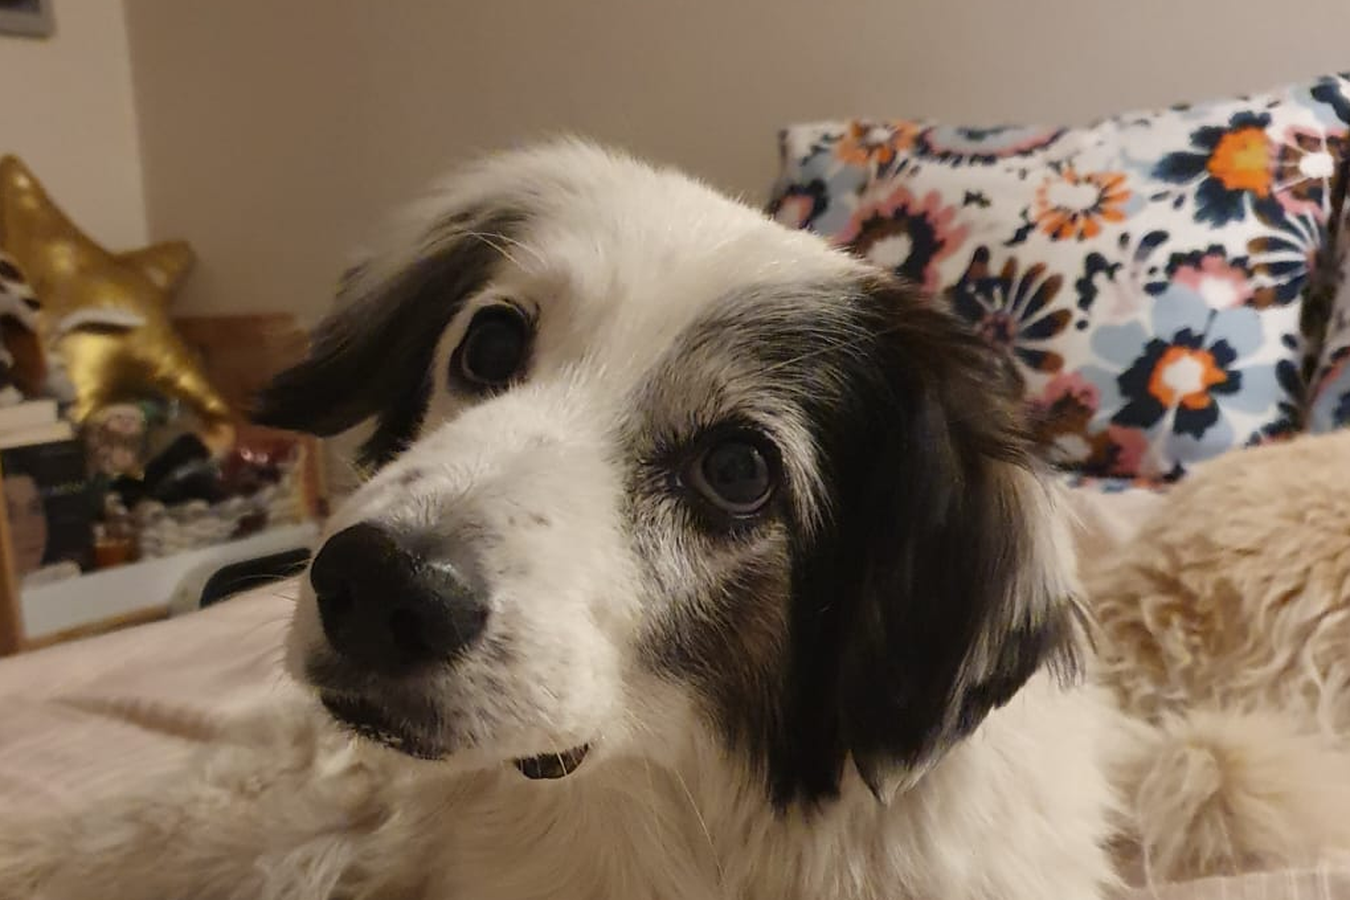
Es un perro. Vuelvan a mirar las manchas.
Ahora que saben, ya no pueden ver sólo manchas.
Foto e imagen de dos tonos propias.
Tres casos
Ver bien, corregirse y no poder corregirse
Caso 1
Ver bien
El lápiz en el vaso vacío.
Se ve derecho y está derecho.
Caso 2
Un error que el saber corrige
Las manchas.
Cuando saben que es un perro, lo ven.
Caso 3
Una ilusión que resiste
El lápiz en el agua.
Saben que está derecho y lo siguen viendo quebrado.
¿Por qué a veces saber cambia lo que vemos, y a veces no?
El recorrido
Lo que vamos a hacer hoy
1
Ilusiones que resisten
Líneas, un tablero, dos grises, nueve puntos: saber no cambia lo que vemos.
2
El cerebro "apuesta"
Una idea de por qué pasa, con mil años de historia.
3
¿De fábrica o aprendido?
Niños que ven por primera vez, un pez y una pregunta vieja.
4
¿Y la inteligencia artificial?
Sus ilusiones, las nuestras y lo que respondieron ocho modelos.
5
Ver, inferir, hacer
Mil años de filosofía sobre qué hacemos al ver, y una respuesta a la pregunta del título.
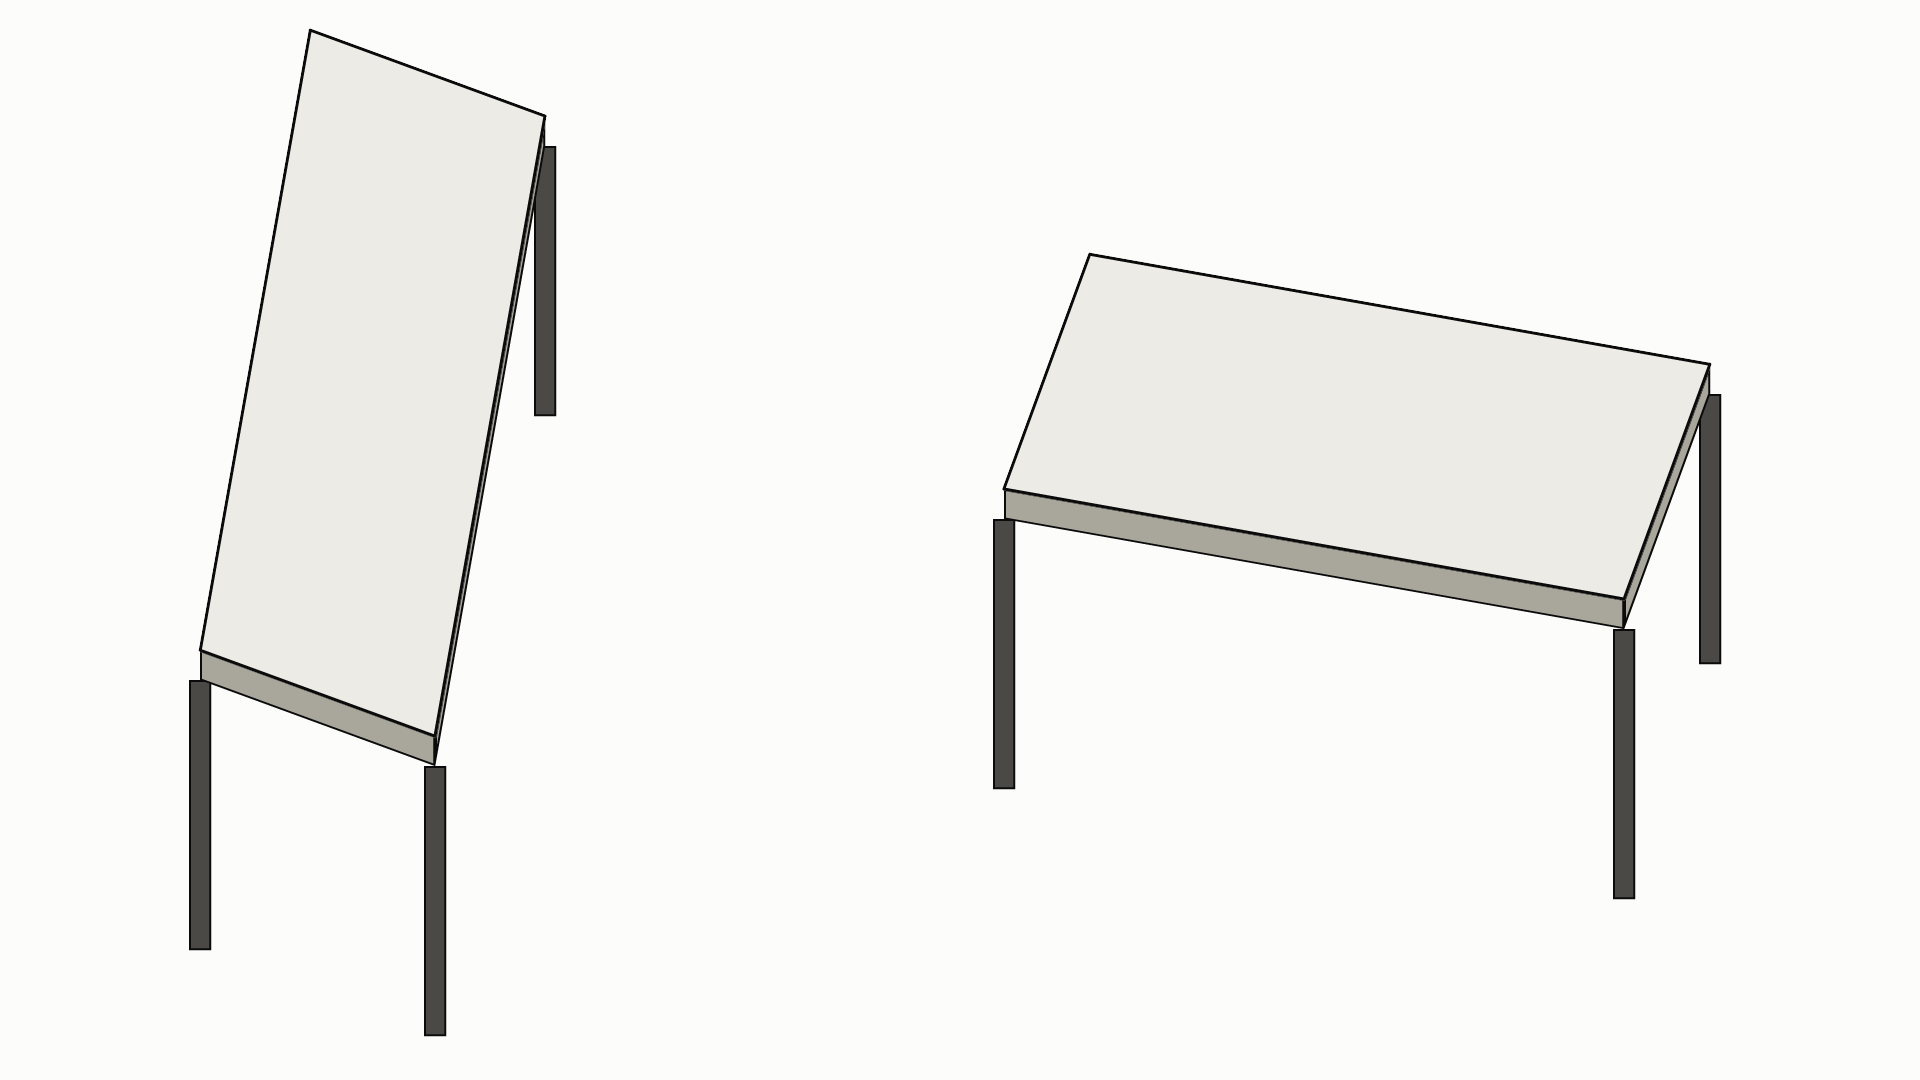
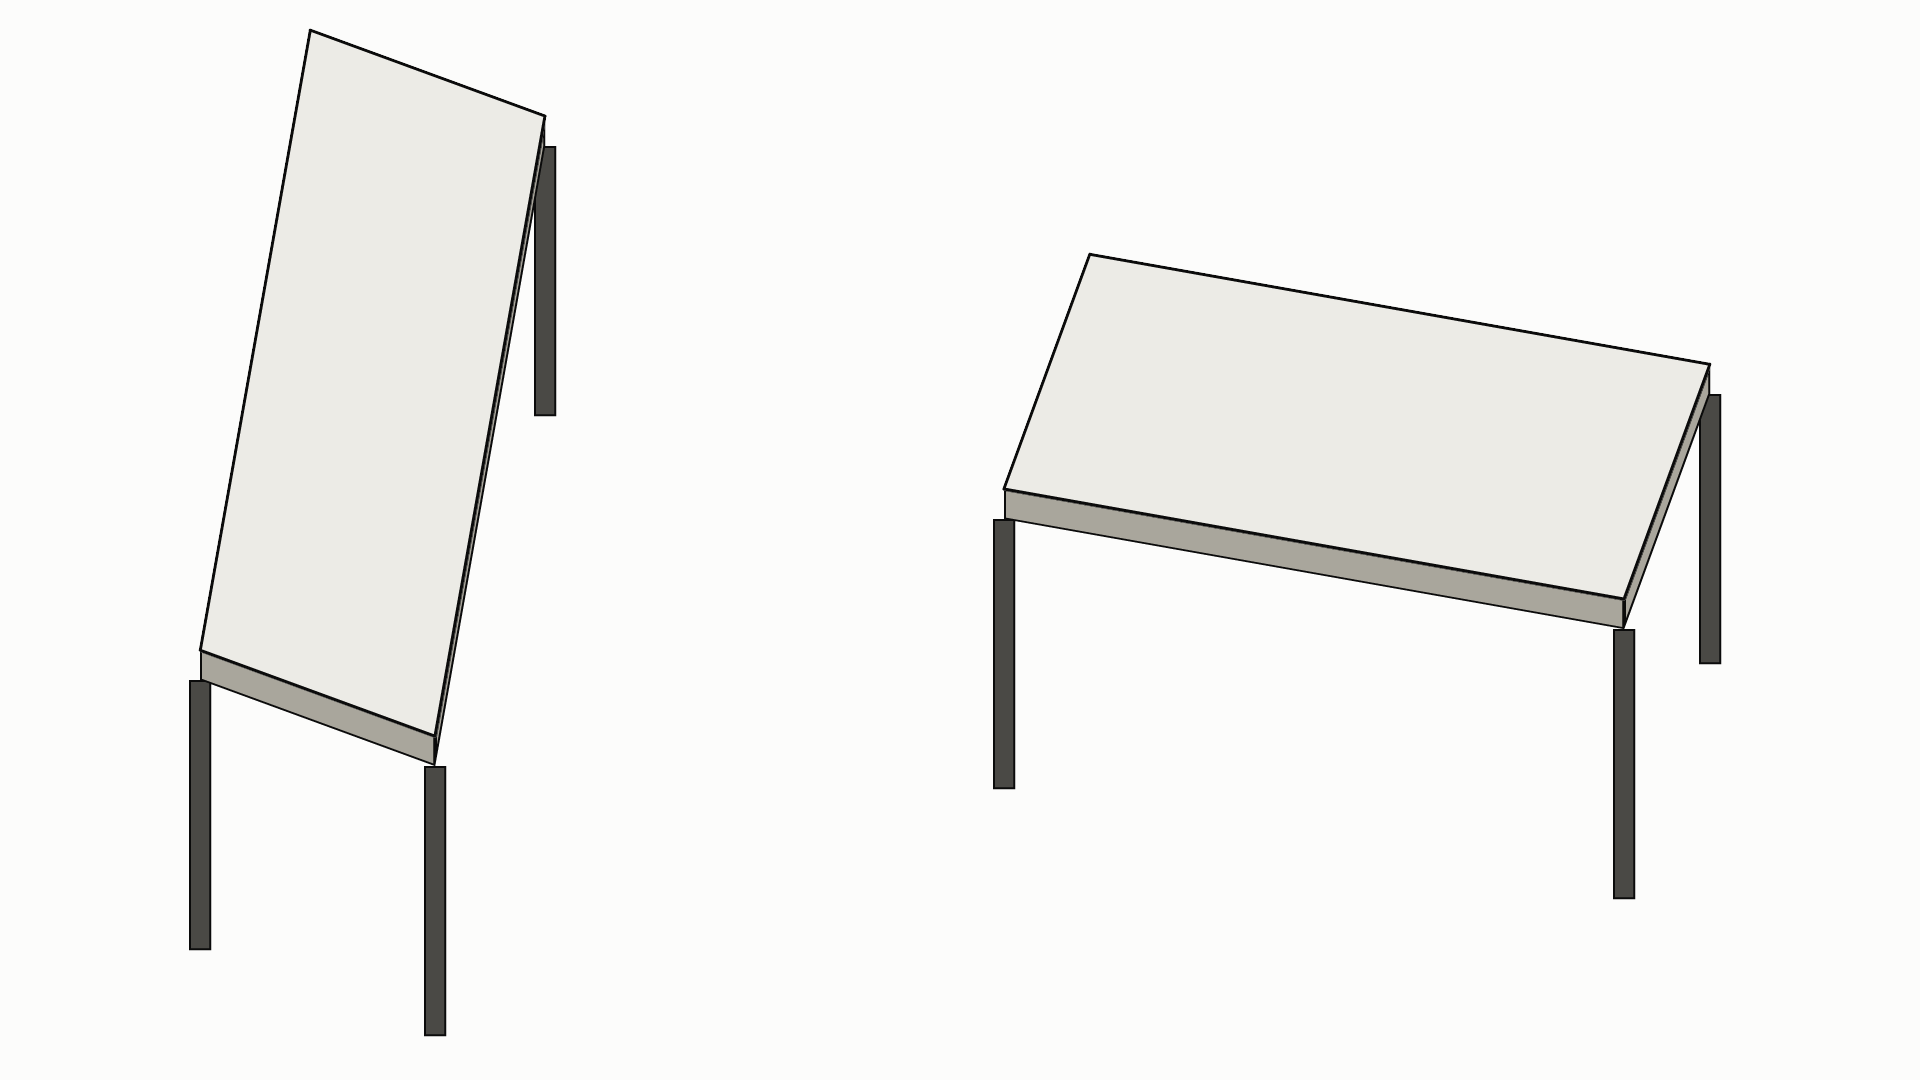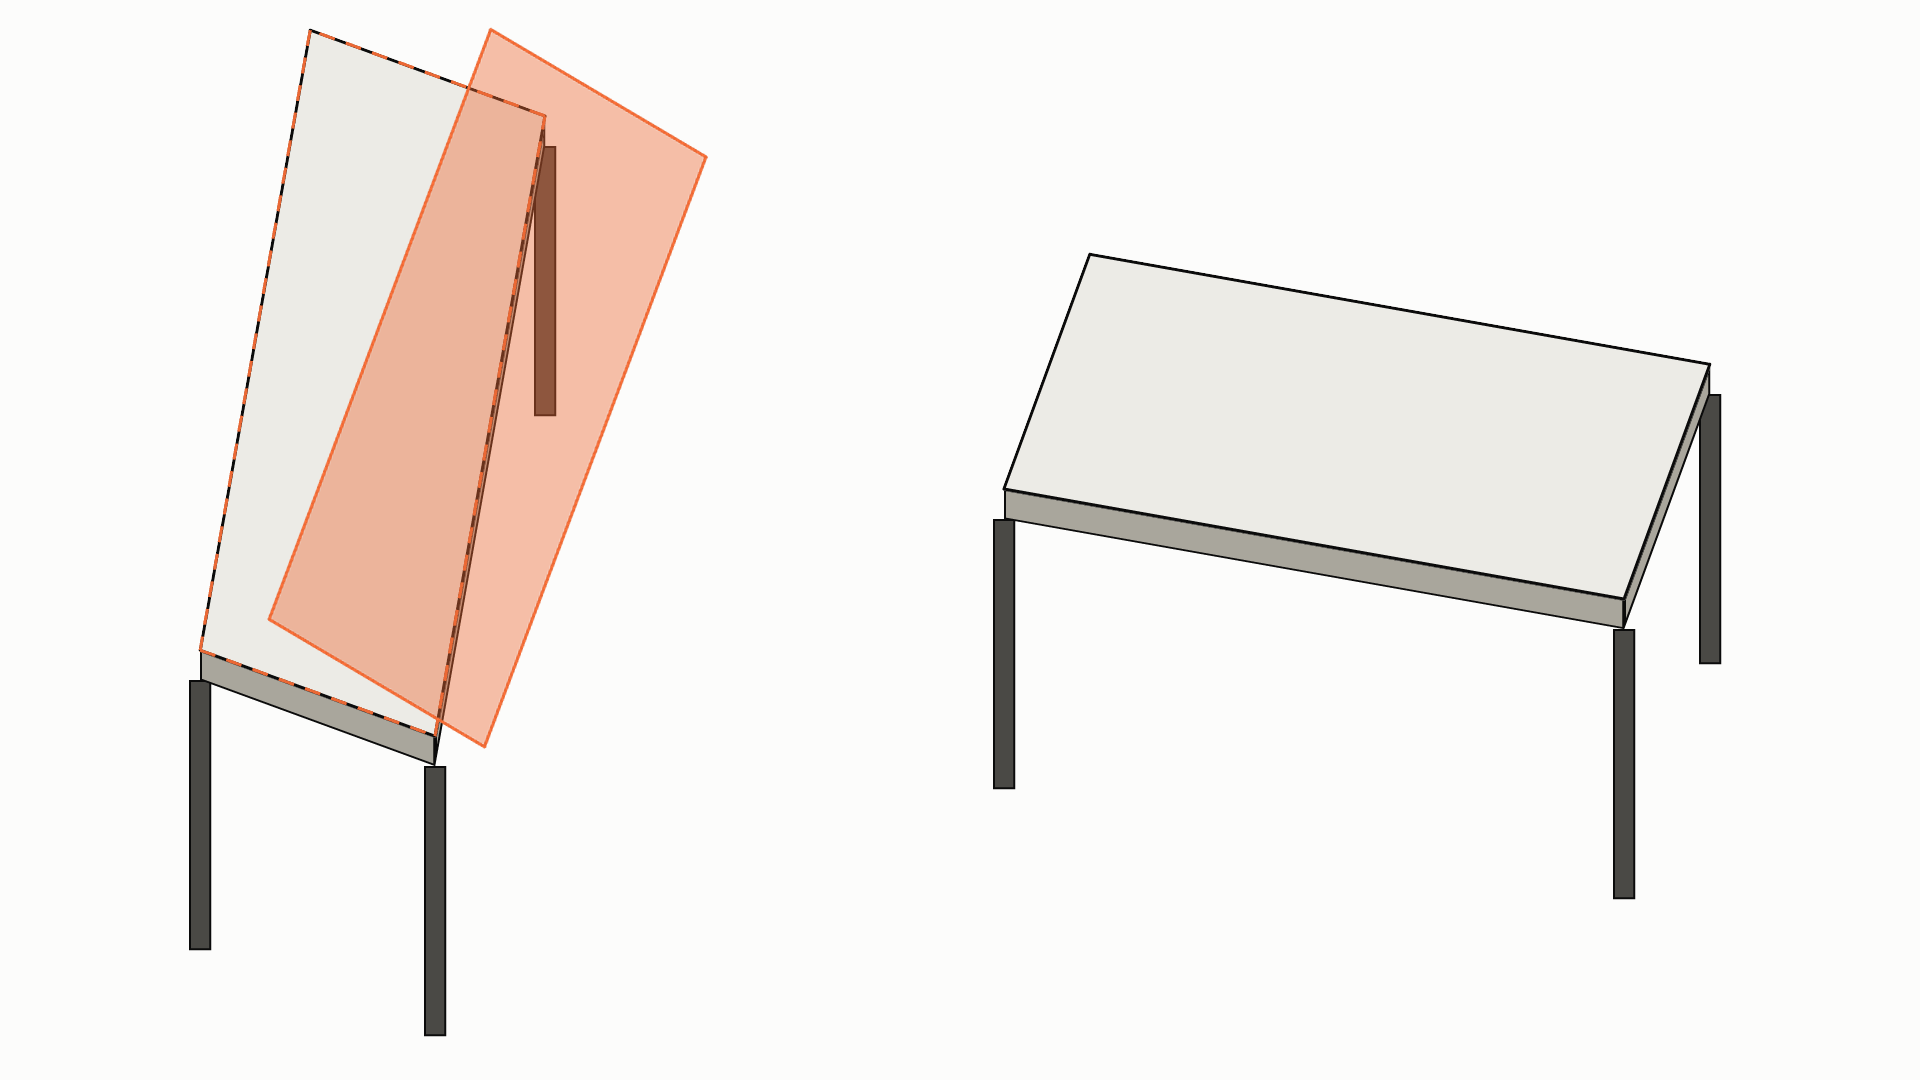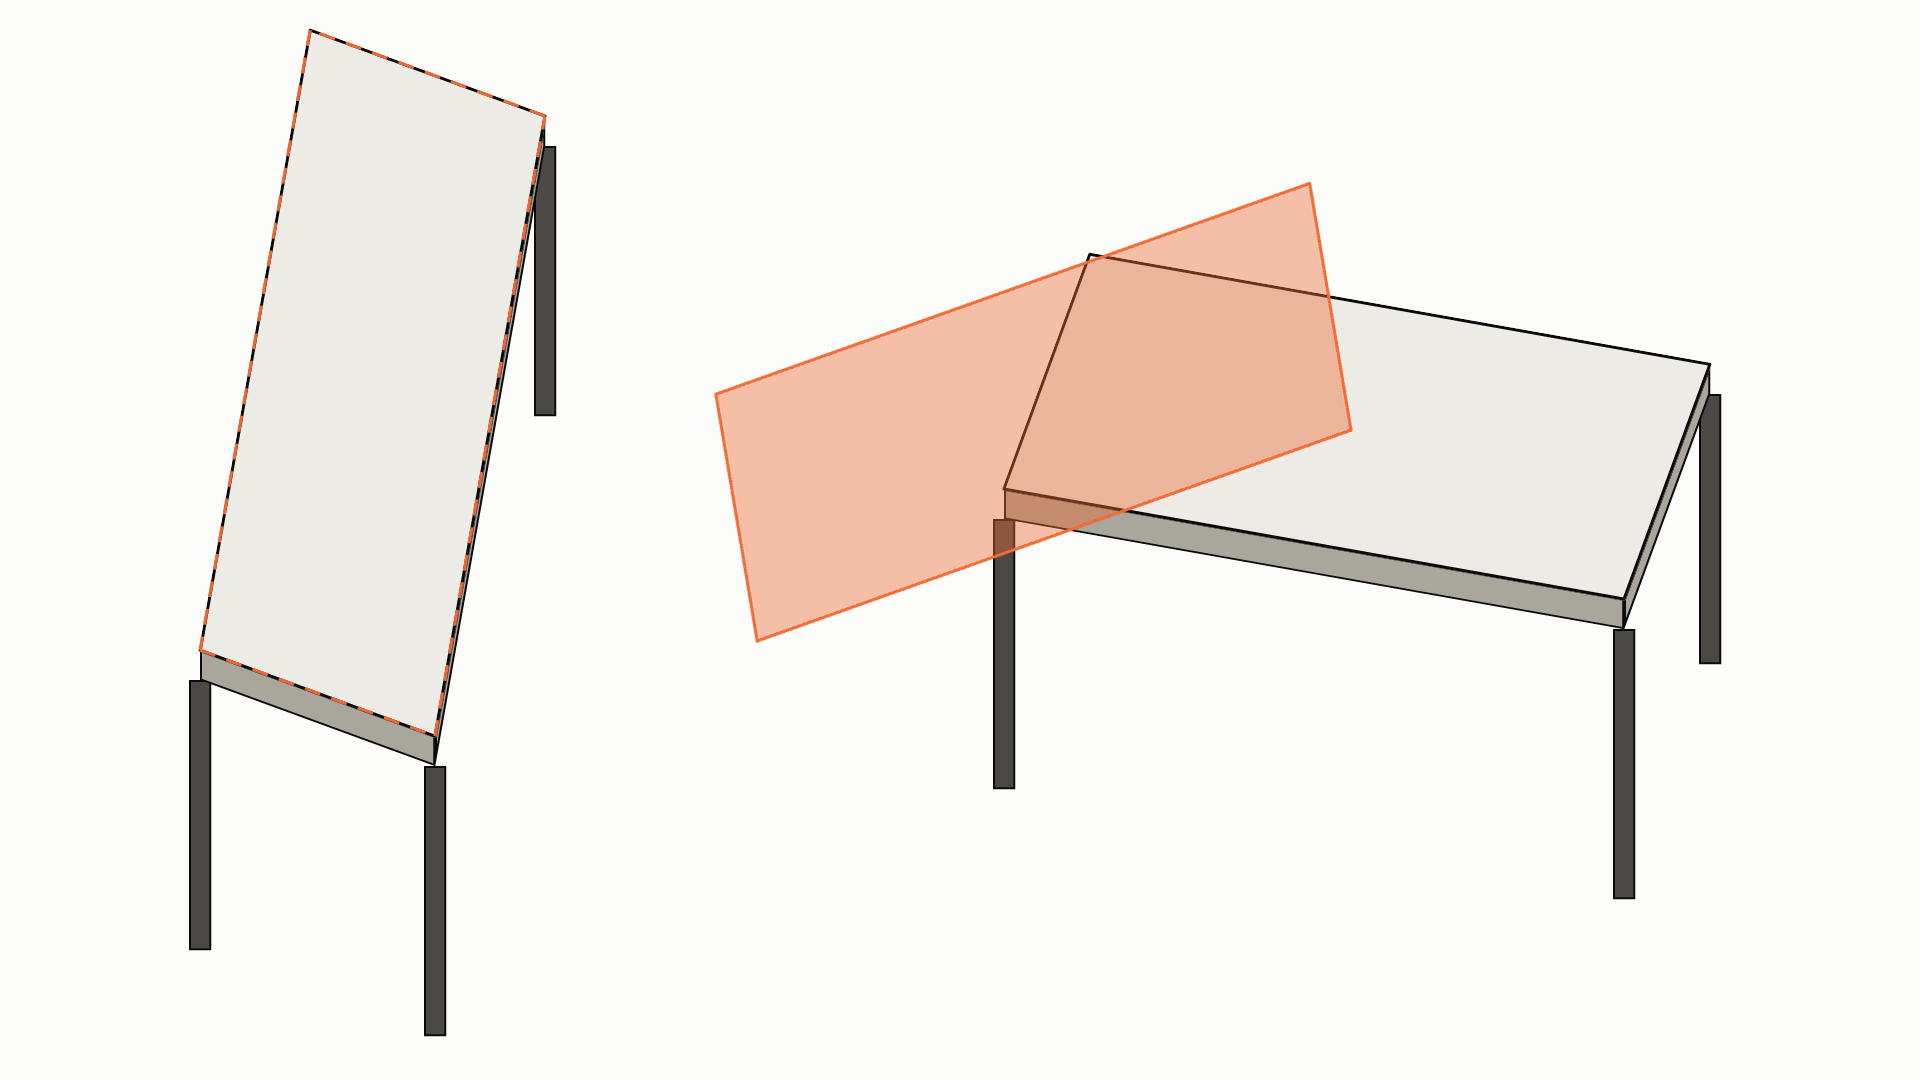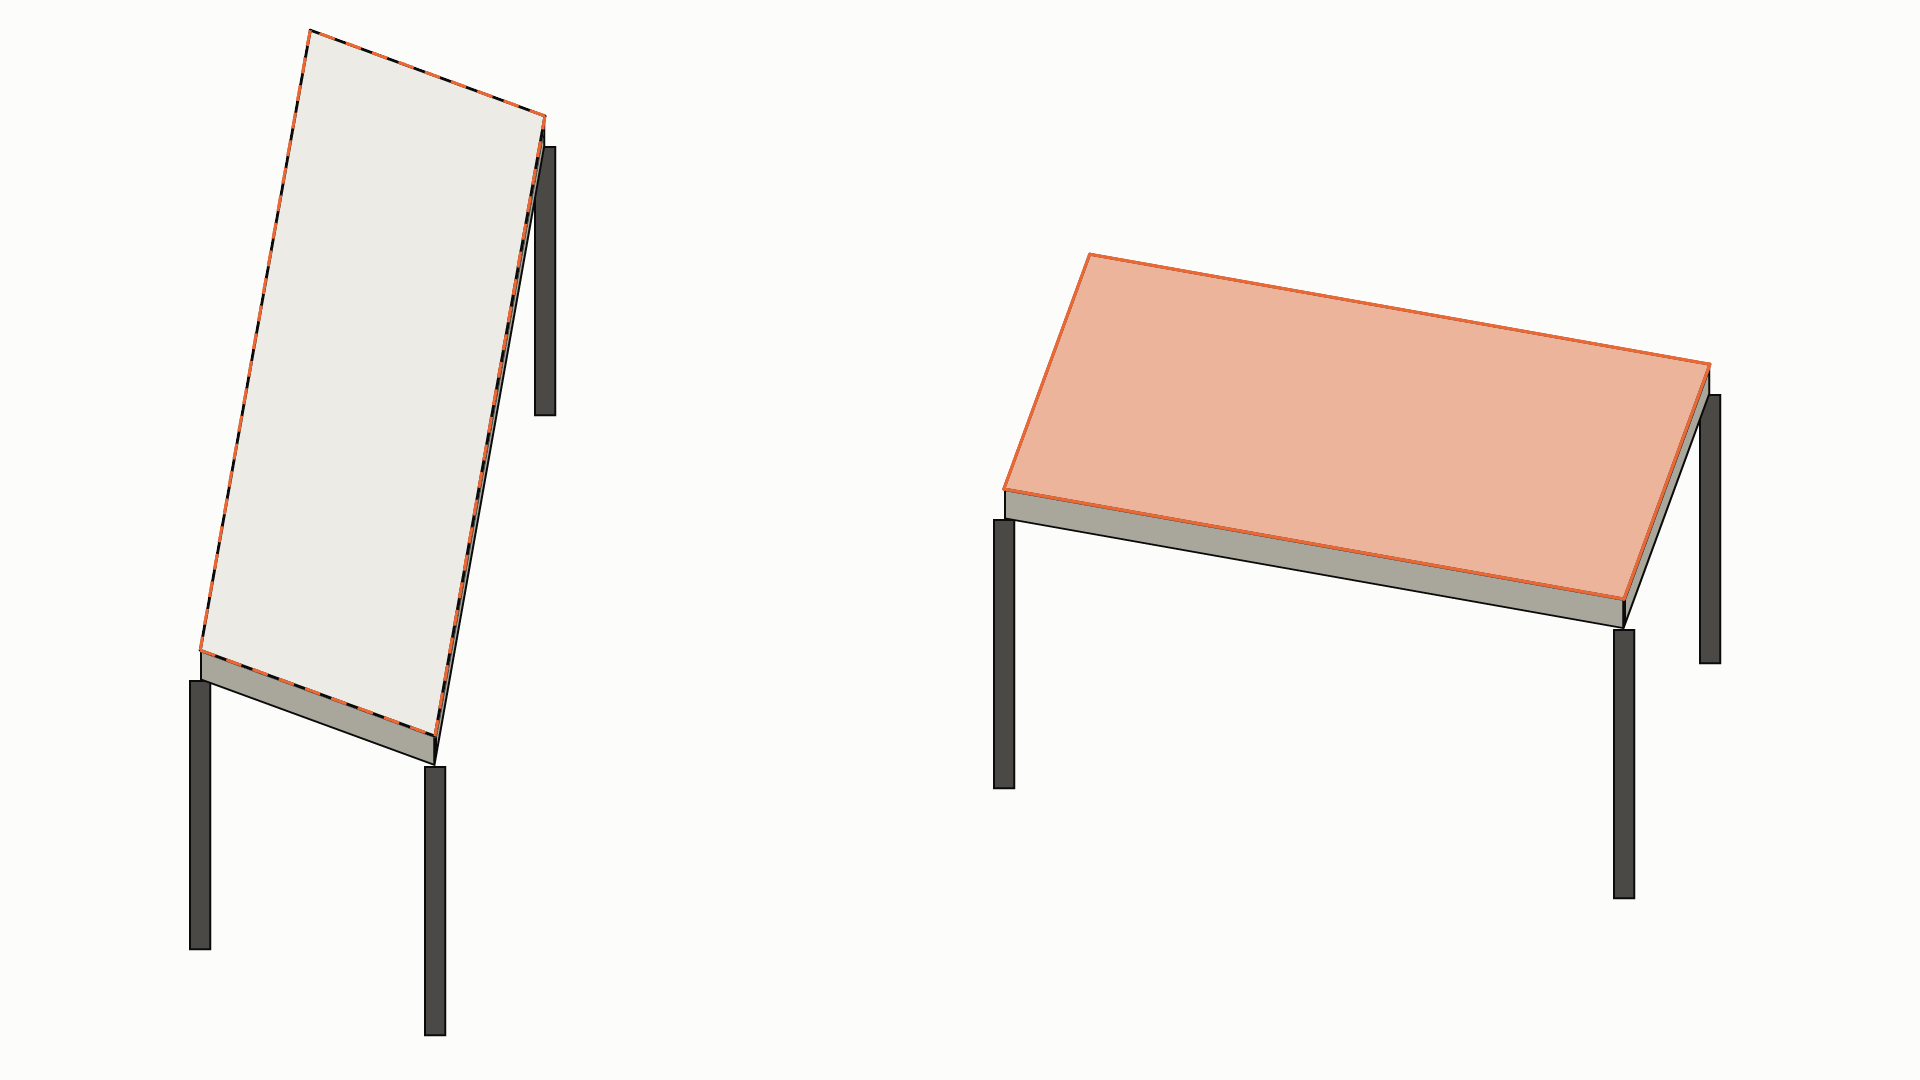
¿Cuál mesa es más larga?
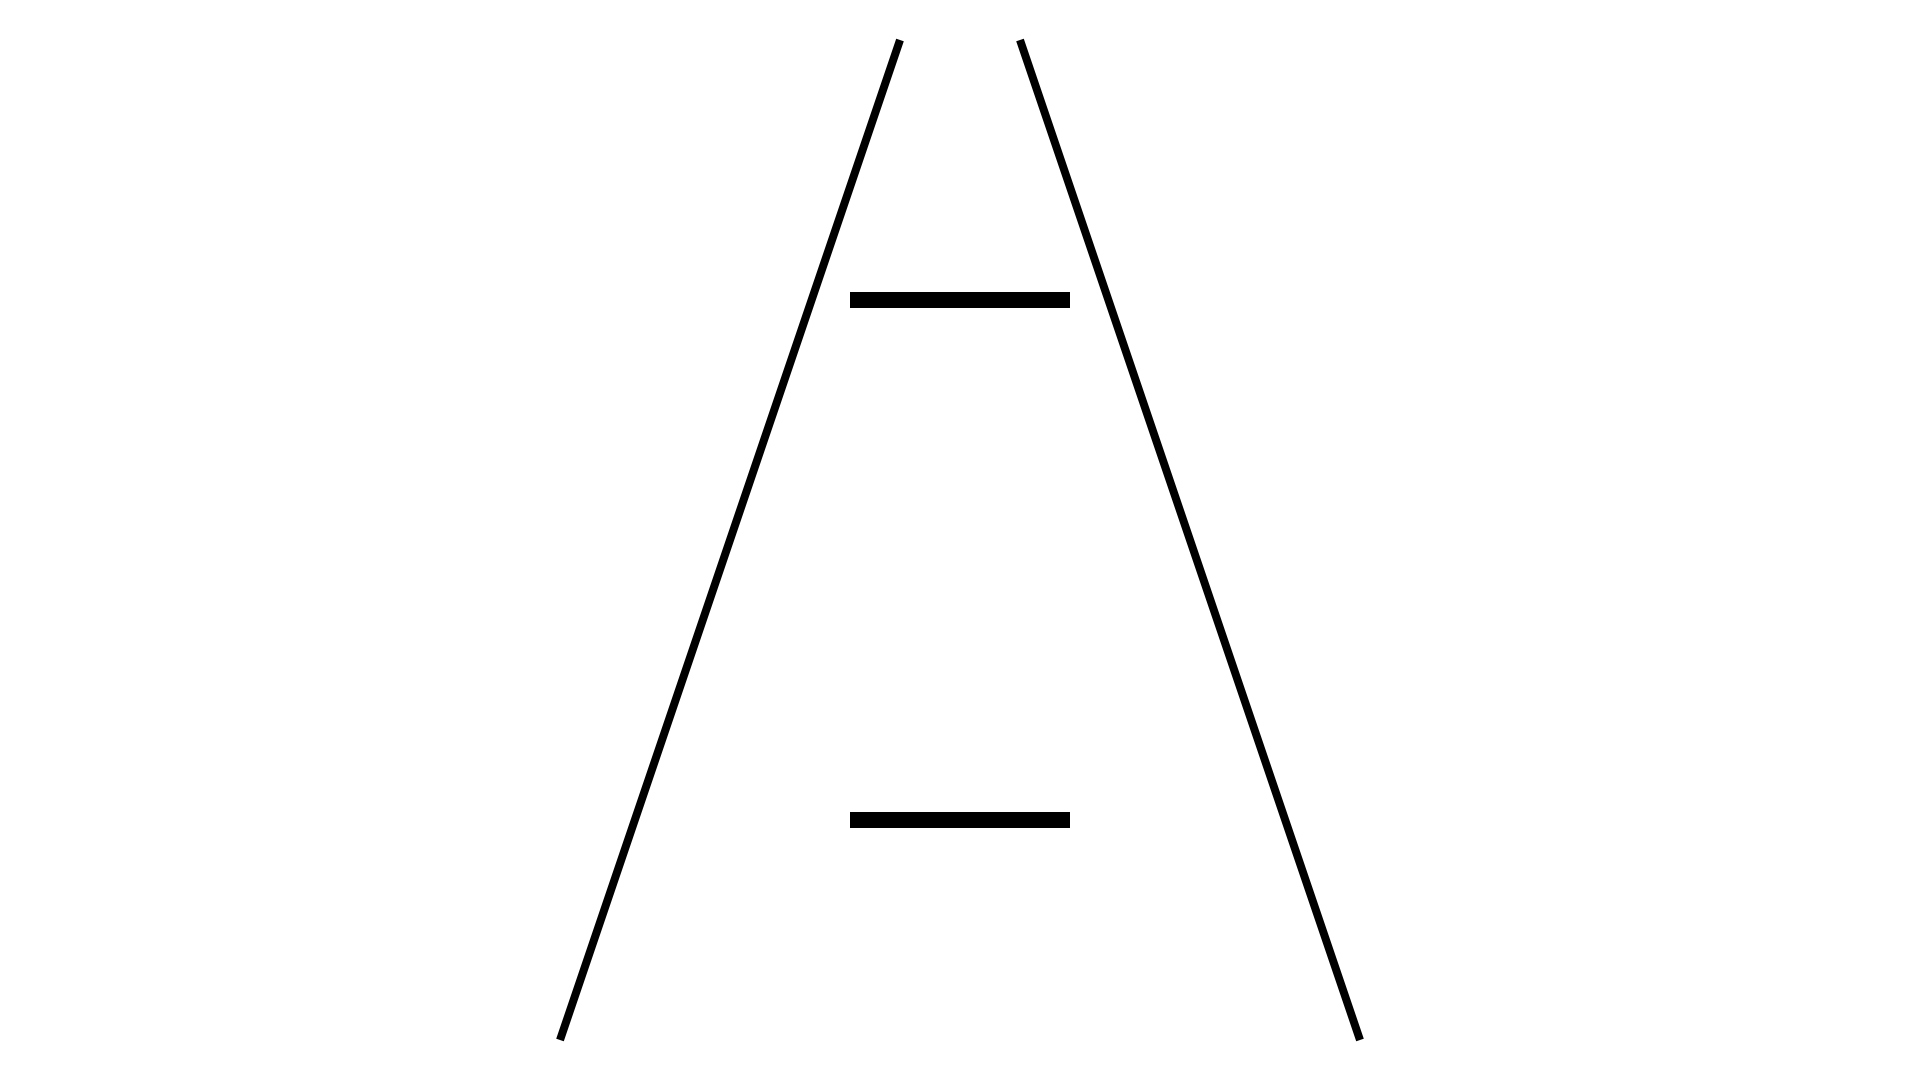
¿Cuál barra es más larga?
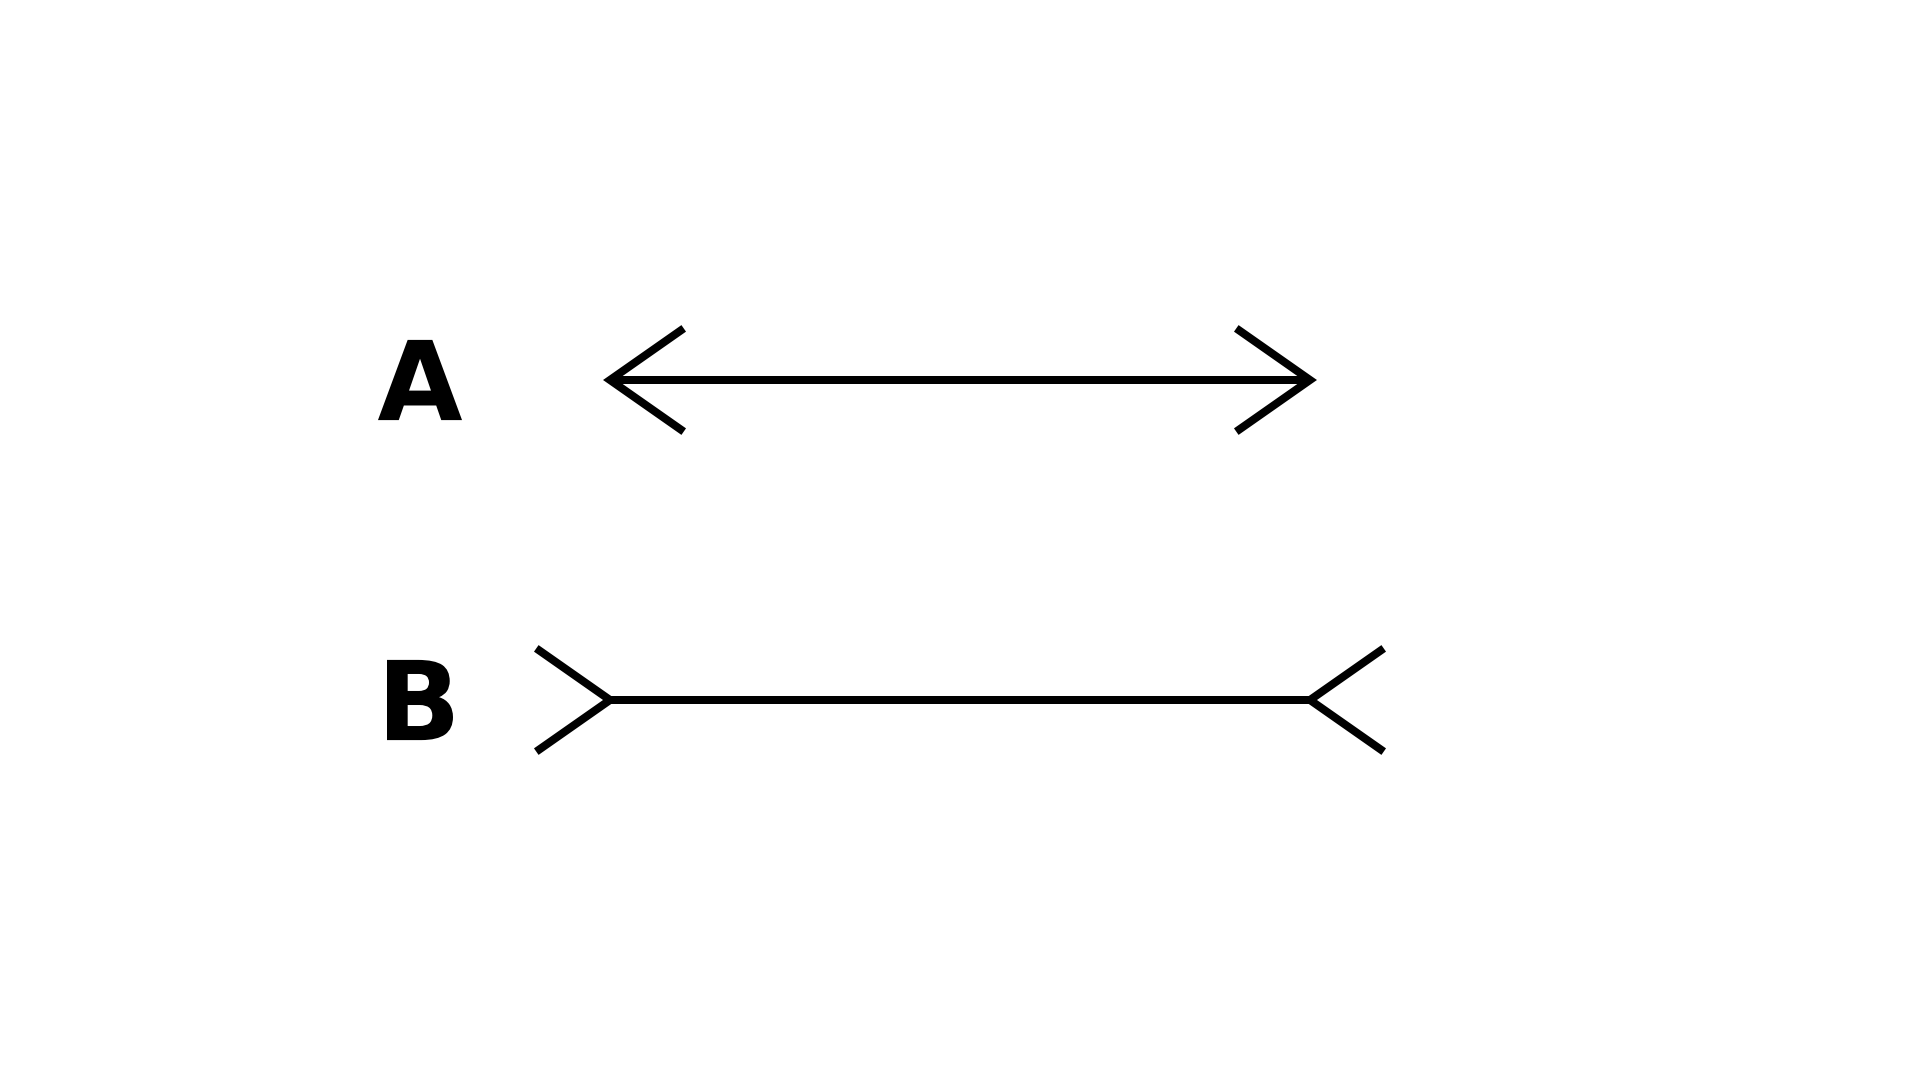
¿Cuál línea es más larga?
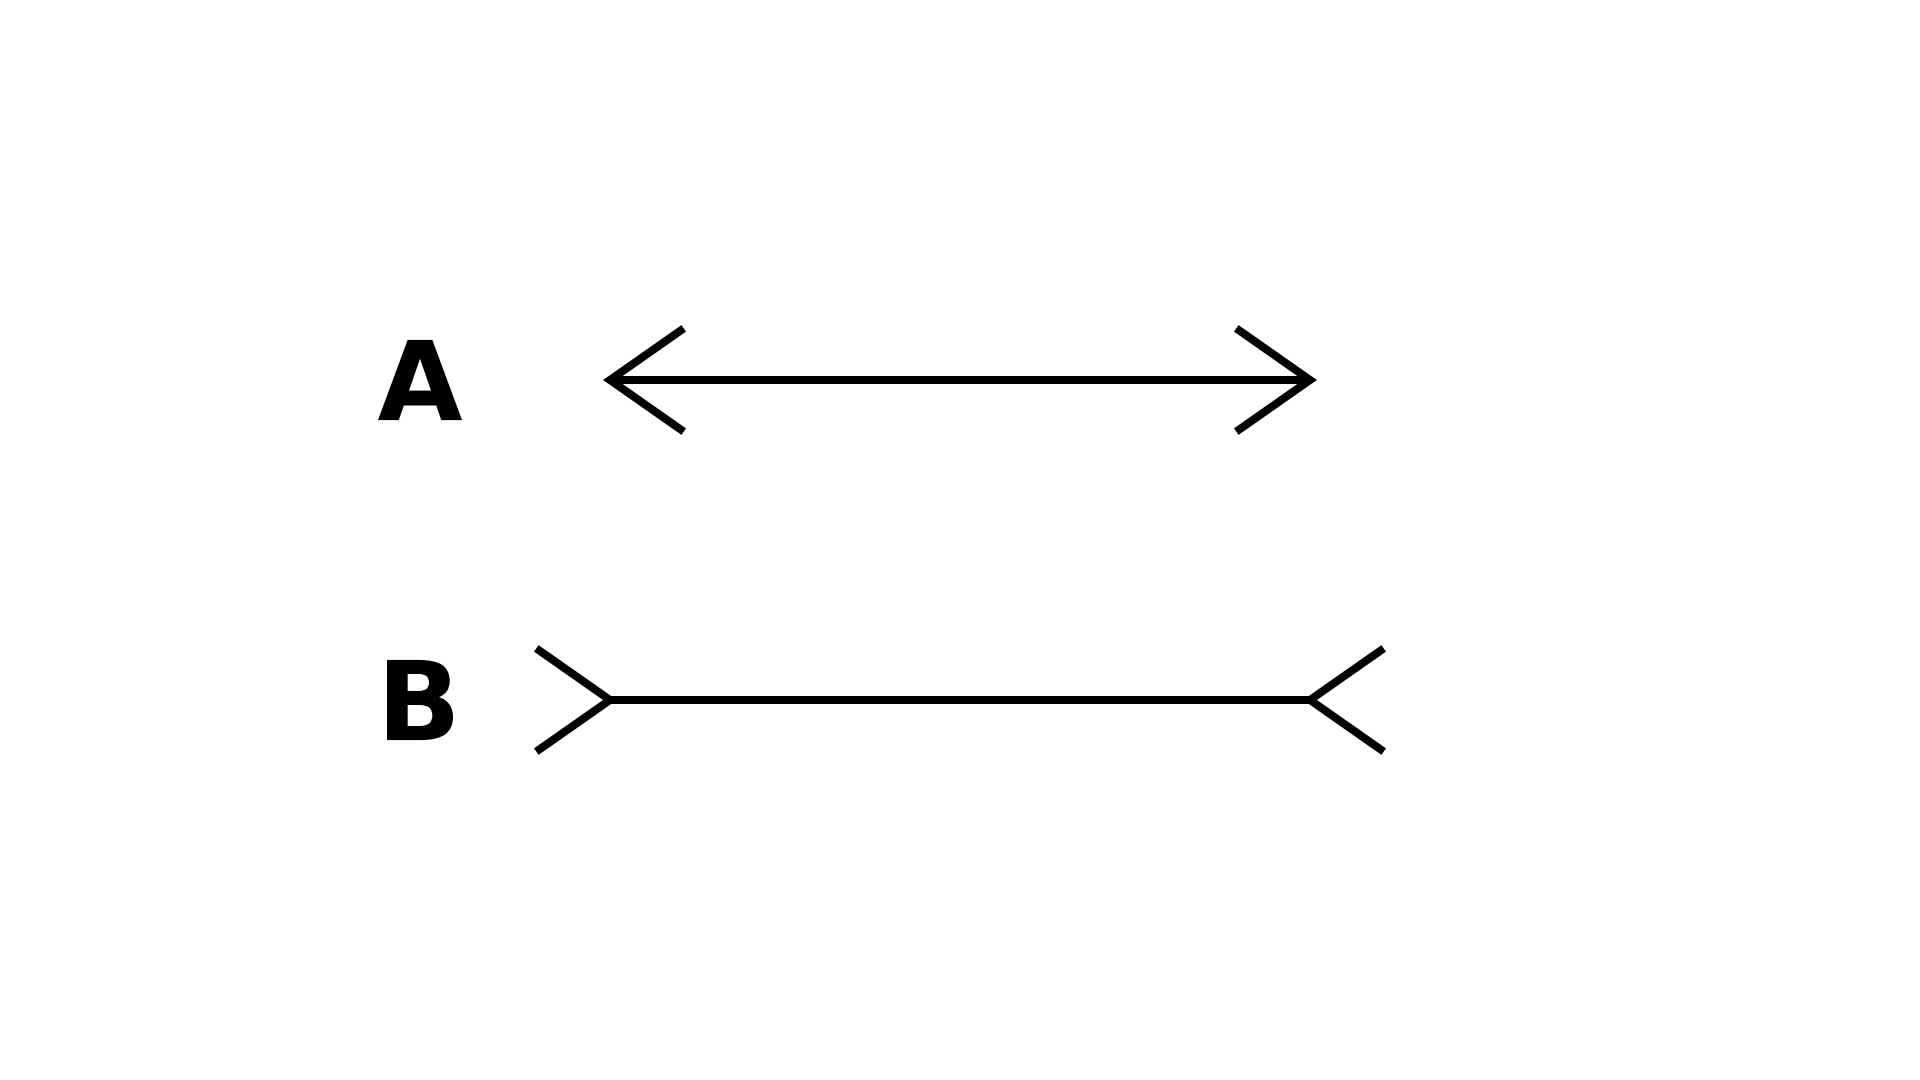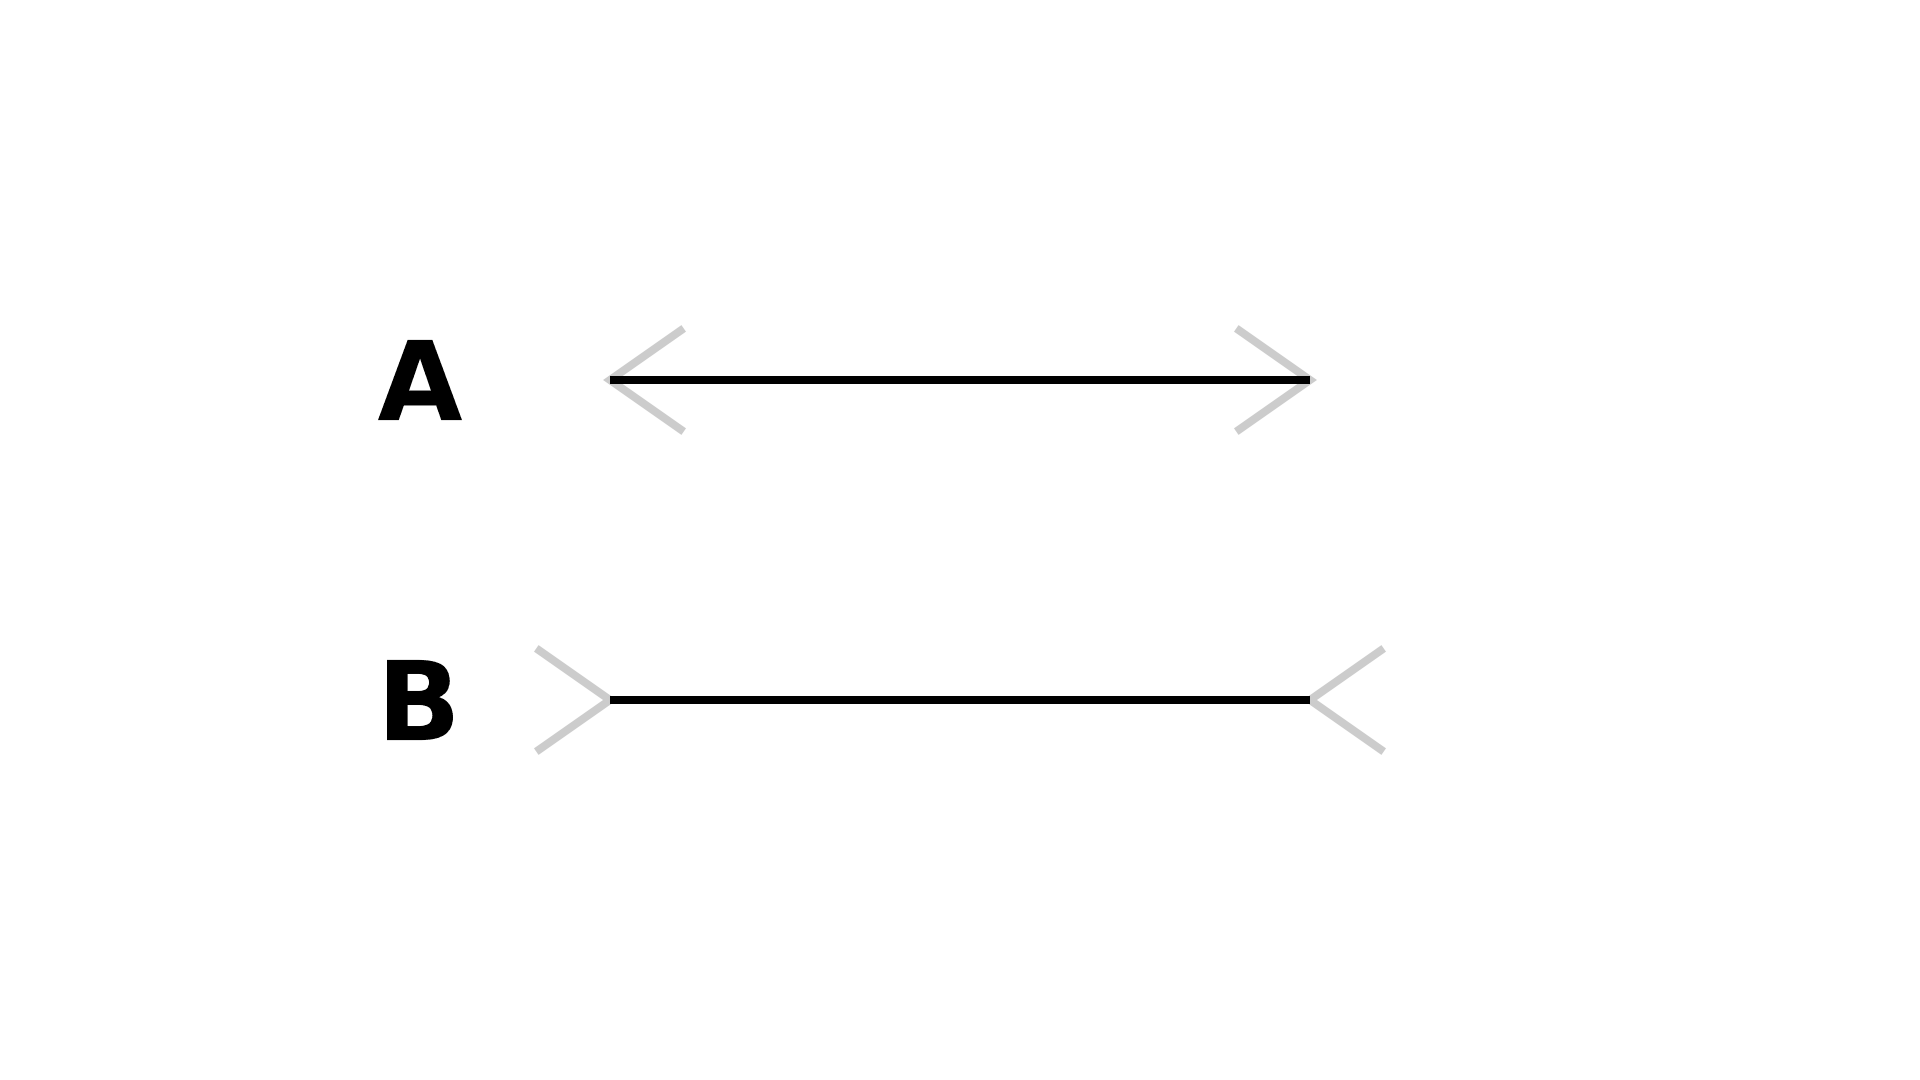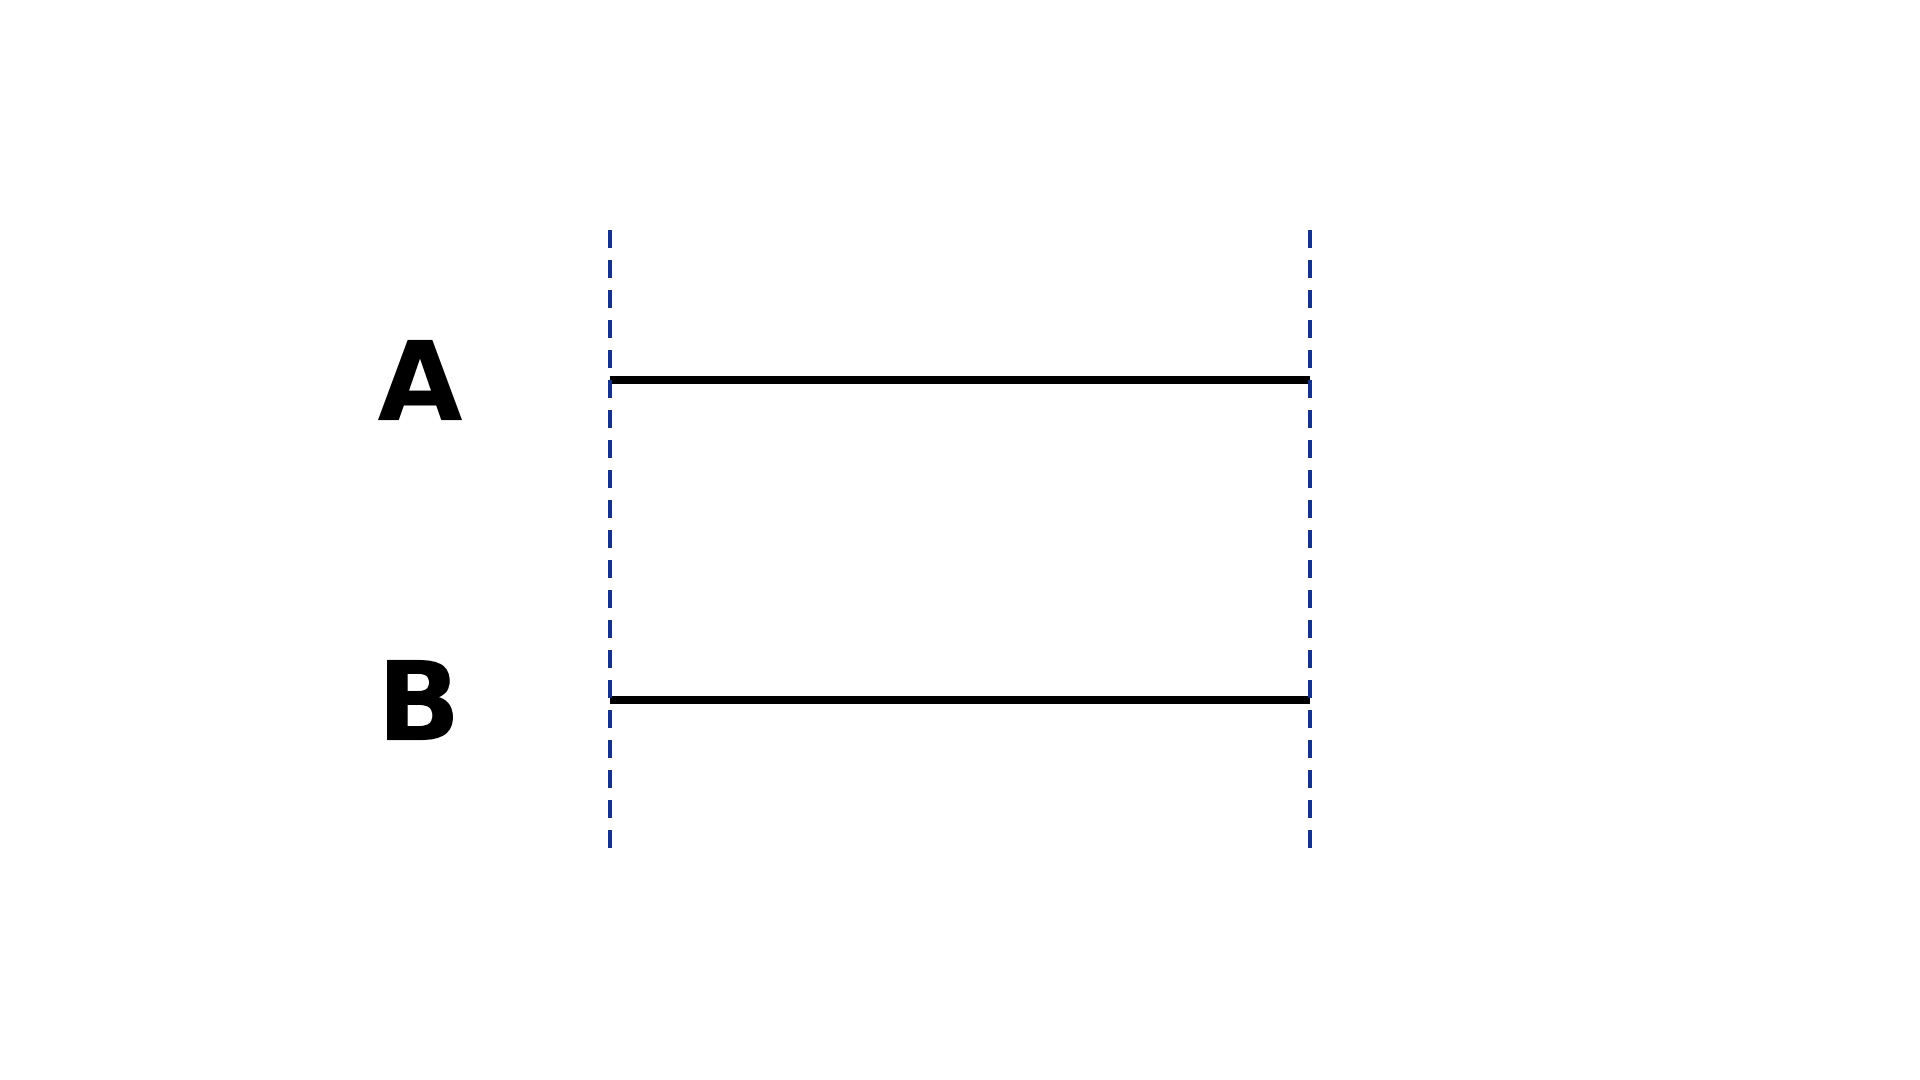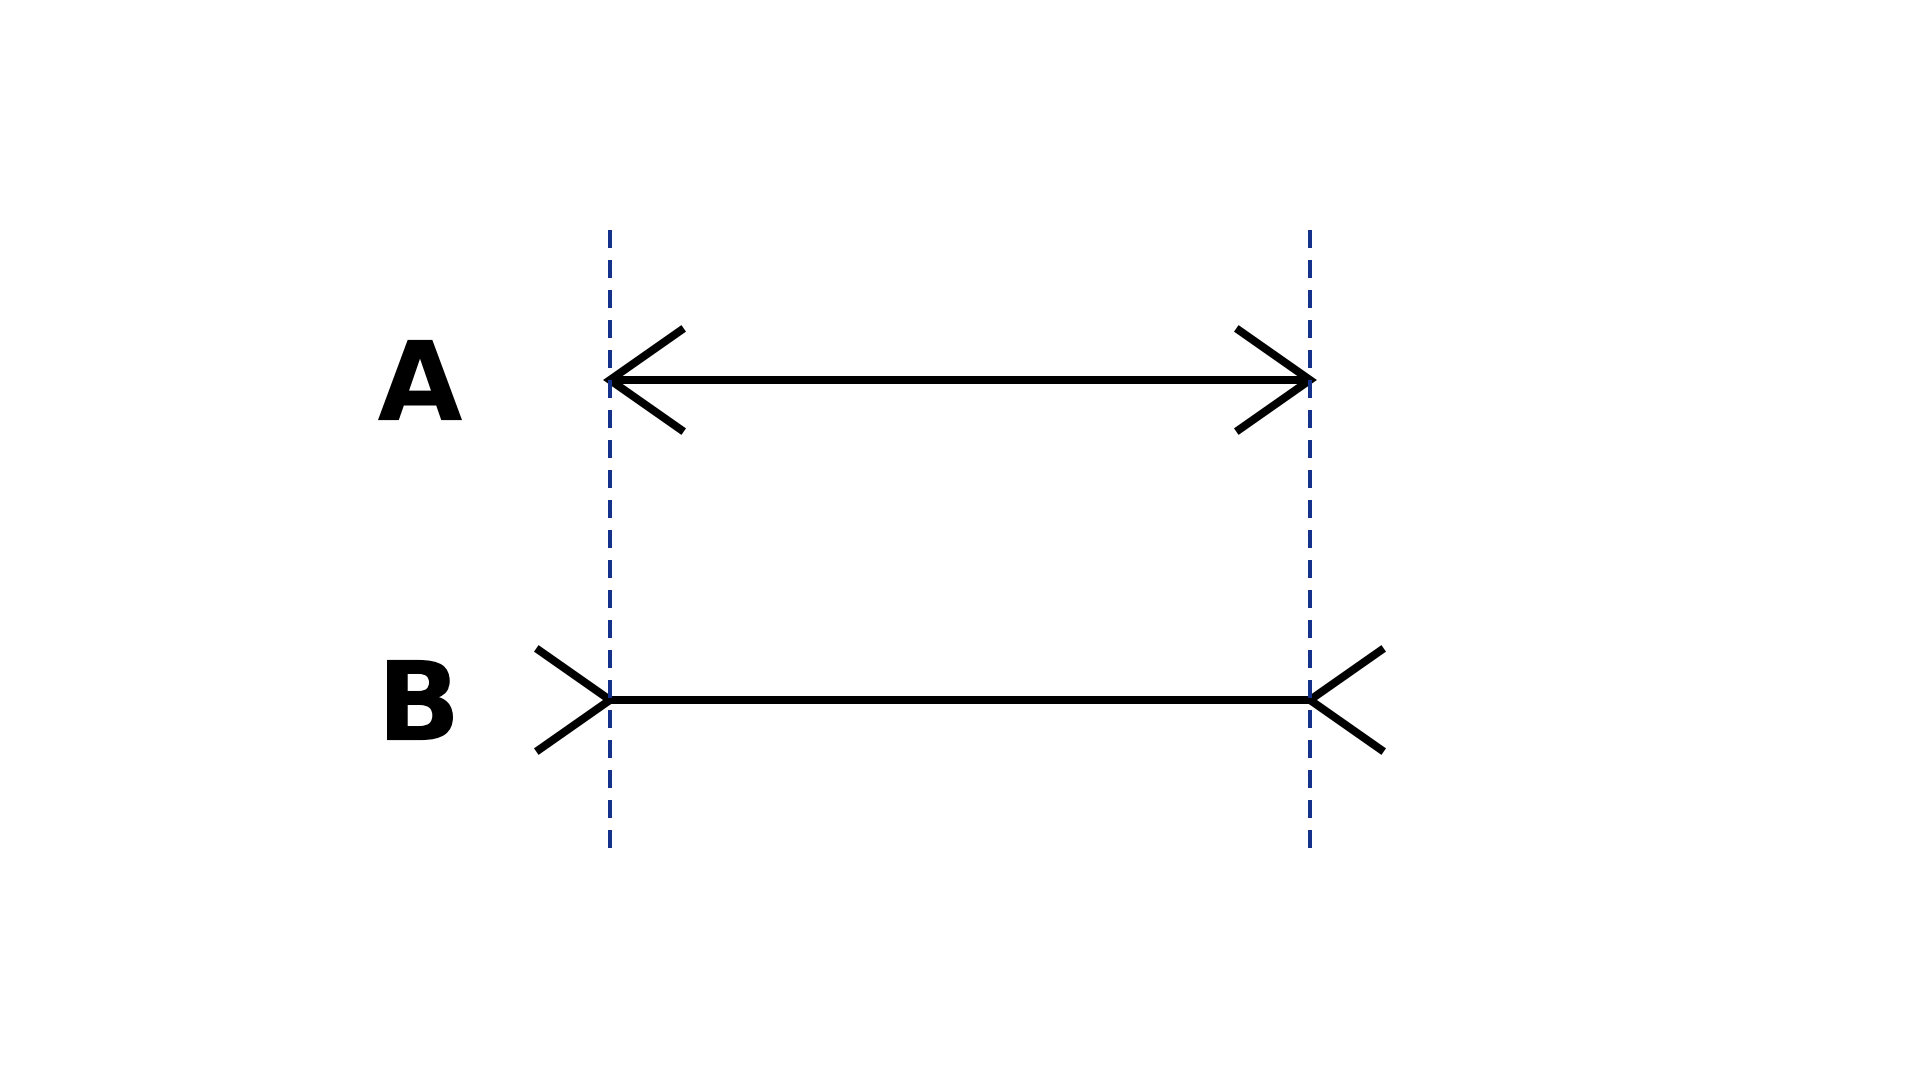
Savardi, Kubovy y Bianchi (2012, p. 77).
Un objeto de verdad, no un dibujo
El cilindro ambiguo
“We cannot correct our interpretations although we logically know that they come from the same objects.”
“No podemos corregir lo que interpretamos, aunque sepamos que viene del mismo objeto.” Kokichi Sugihara, su autor.
Kokichi Sugihara, cilindro ambiguo, segundo lugar en el Best Illusion of the Year Contest 2016. Video y página de sus autores (todos los derechos reservados): se reproduce desde YouTube.
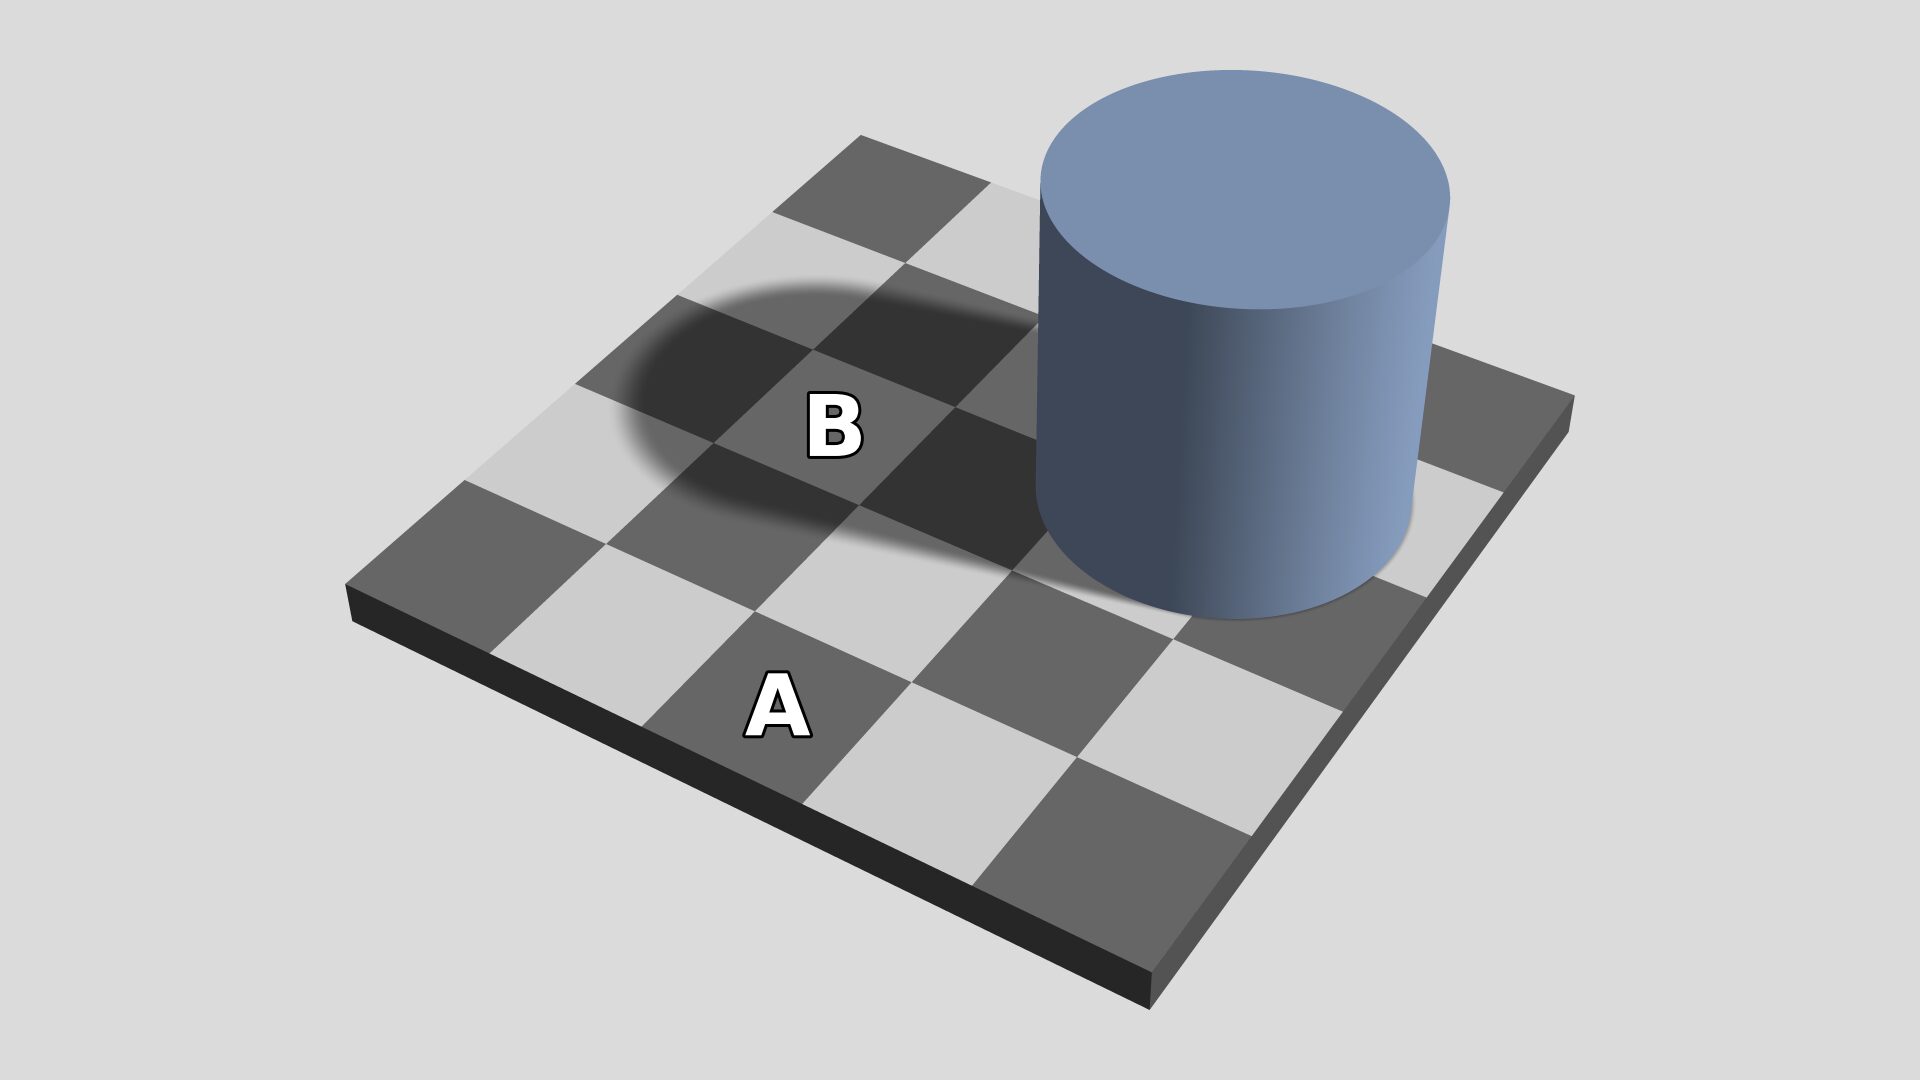
¿Cuál casilla es más clara, la A o la B?
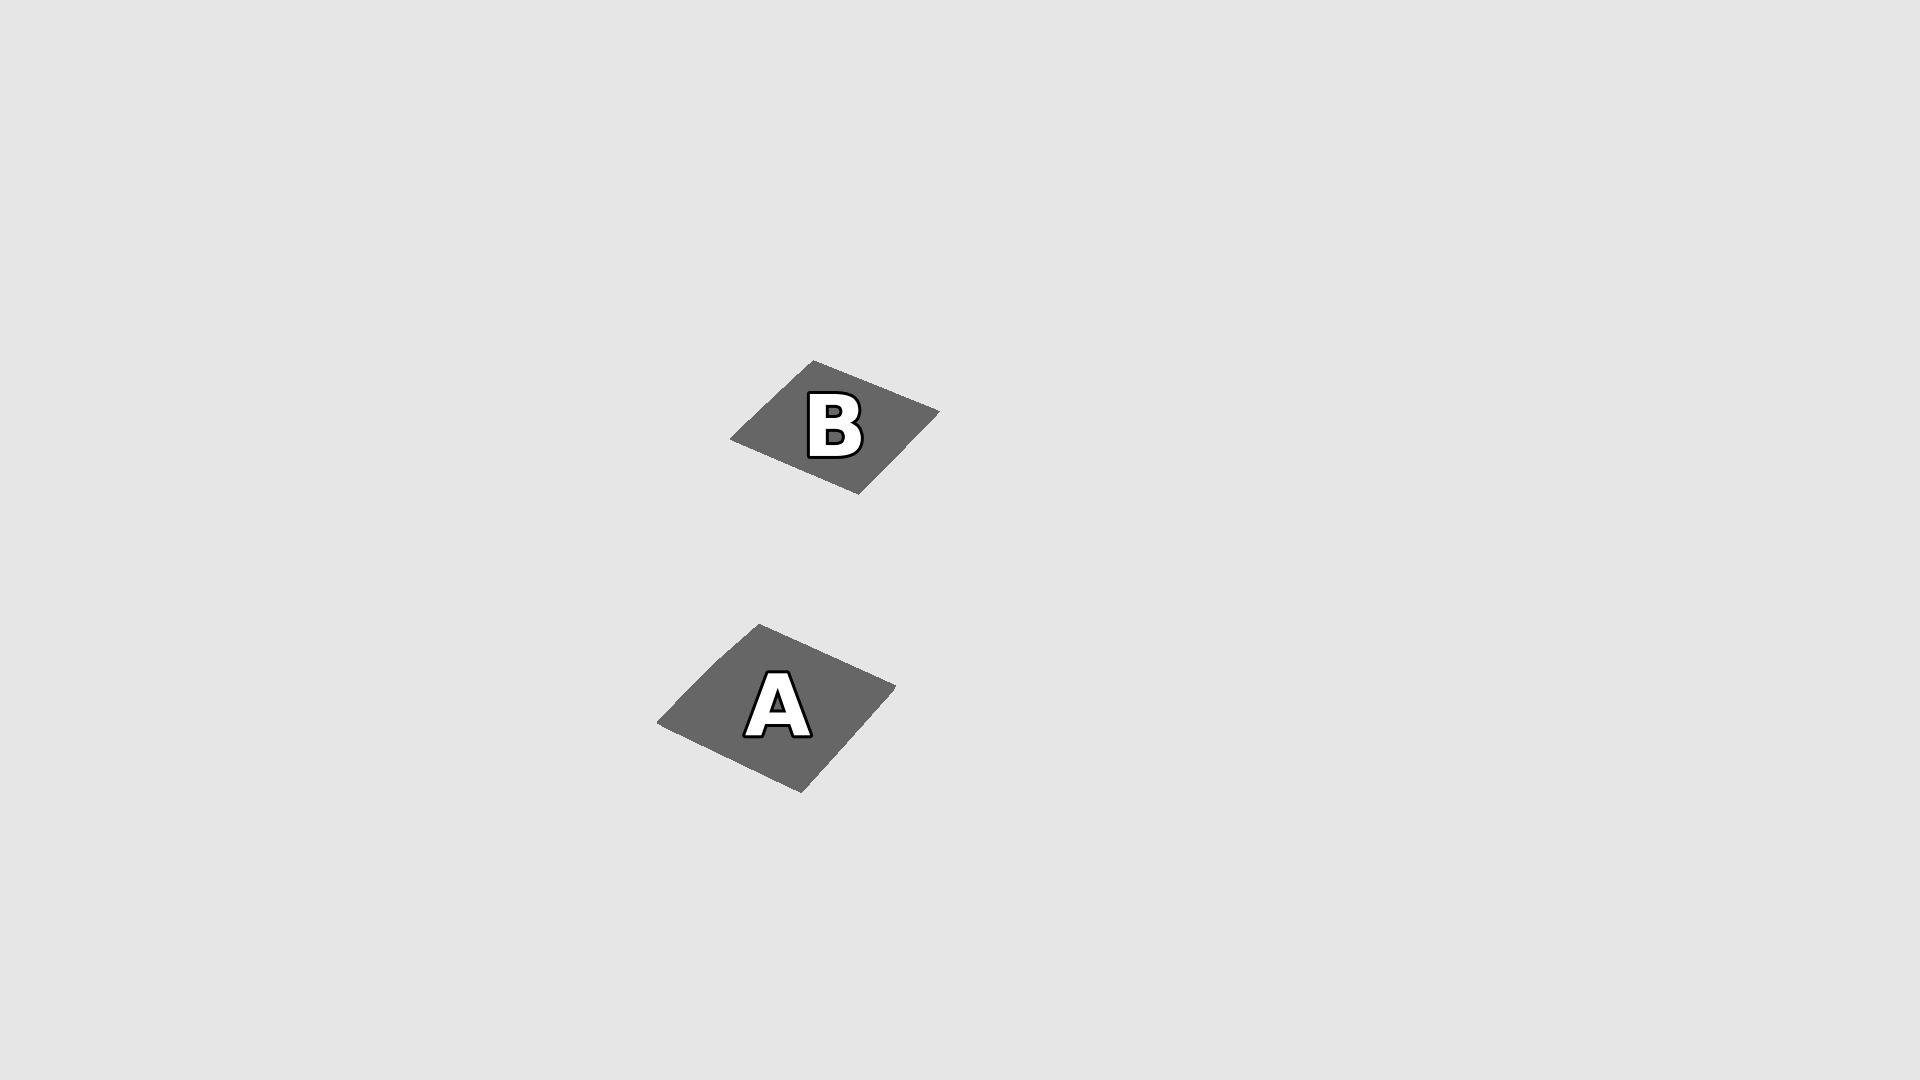
Tapé todo lo demás. ¿Y ahora?
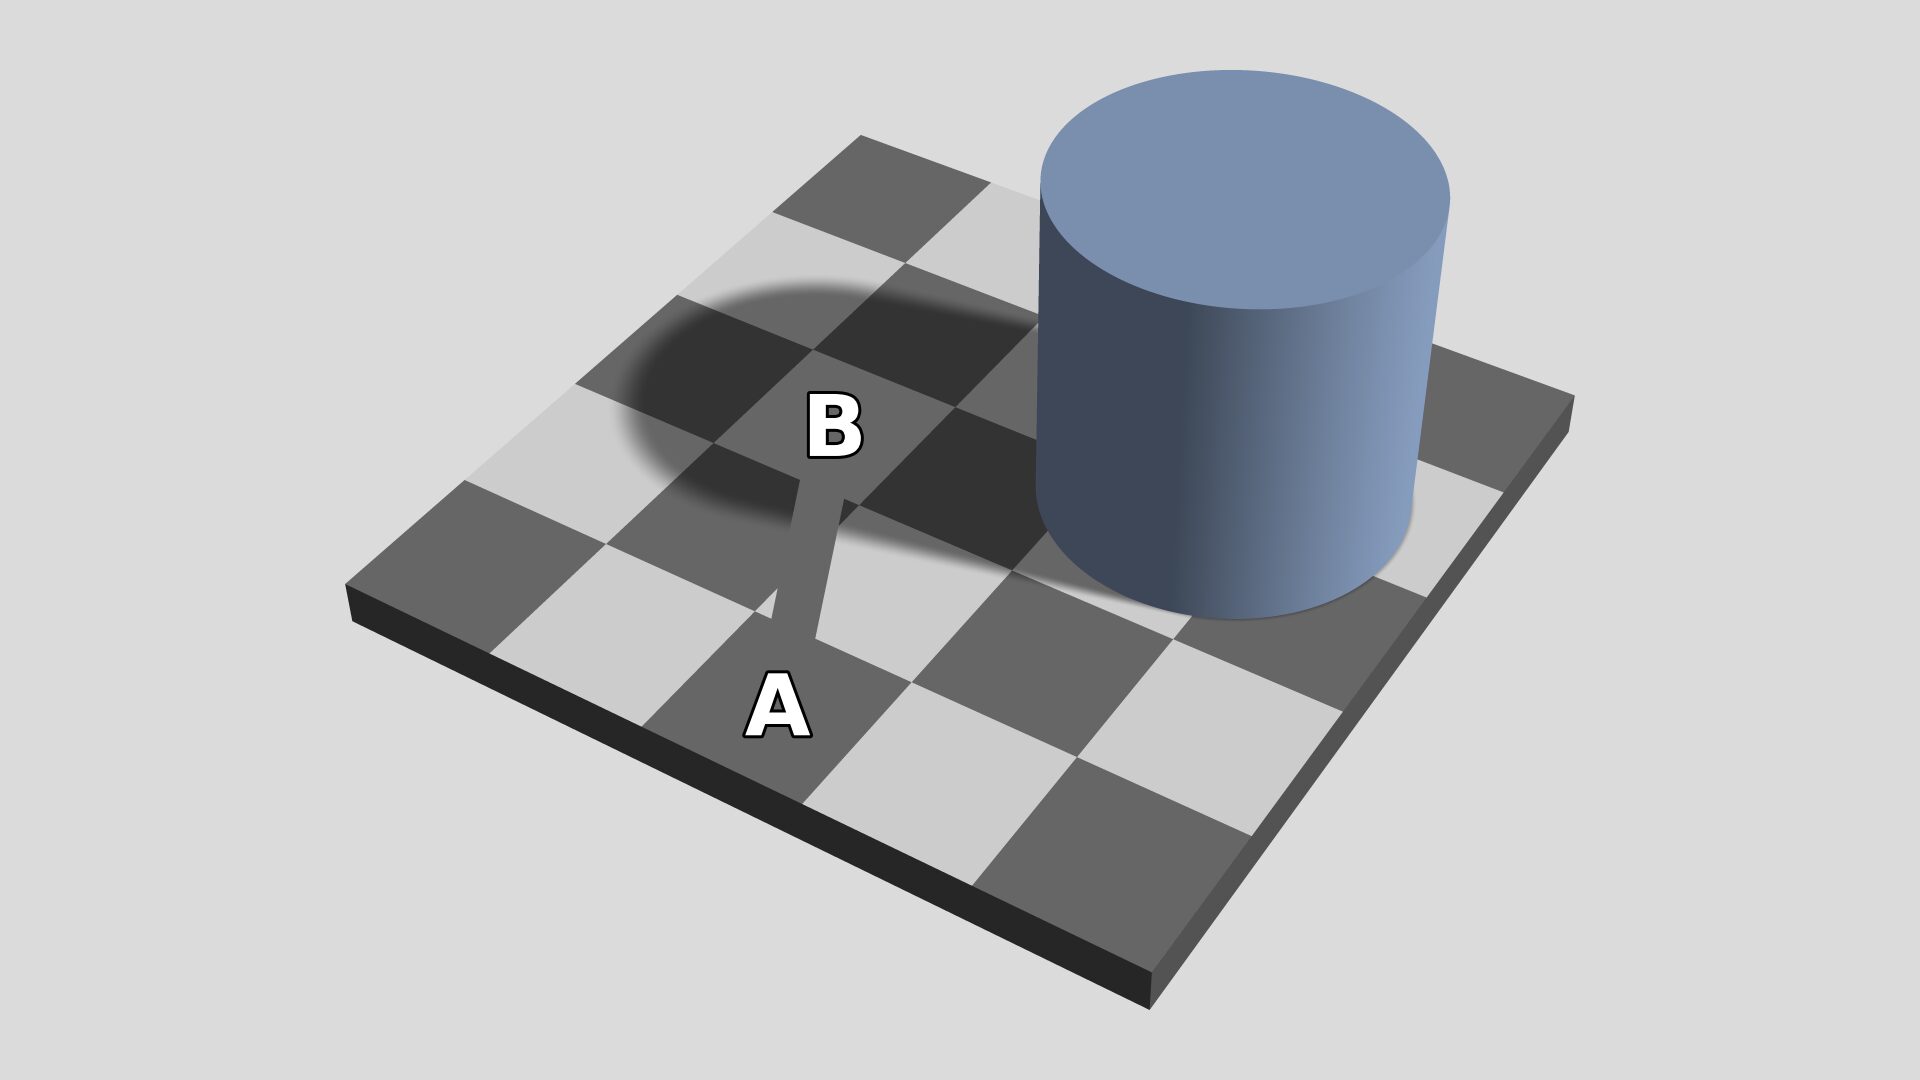
Una franja del mismo gris une A y B.
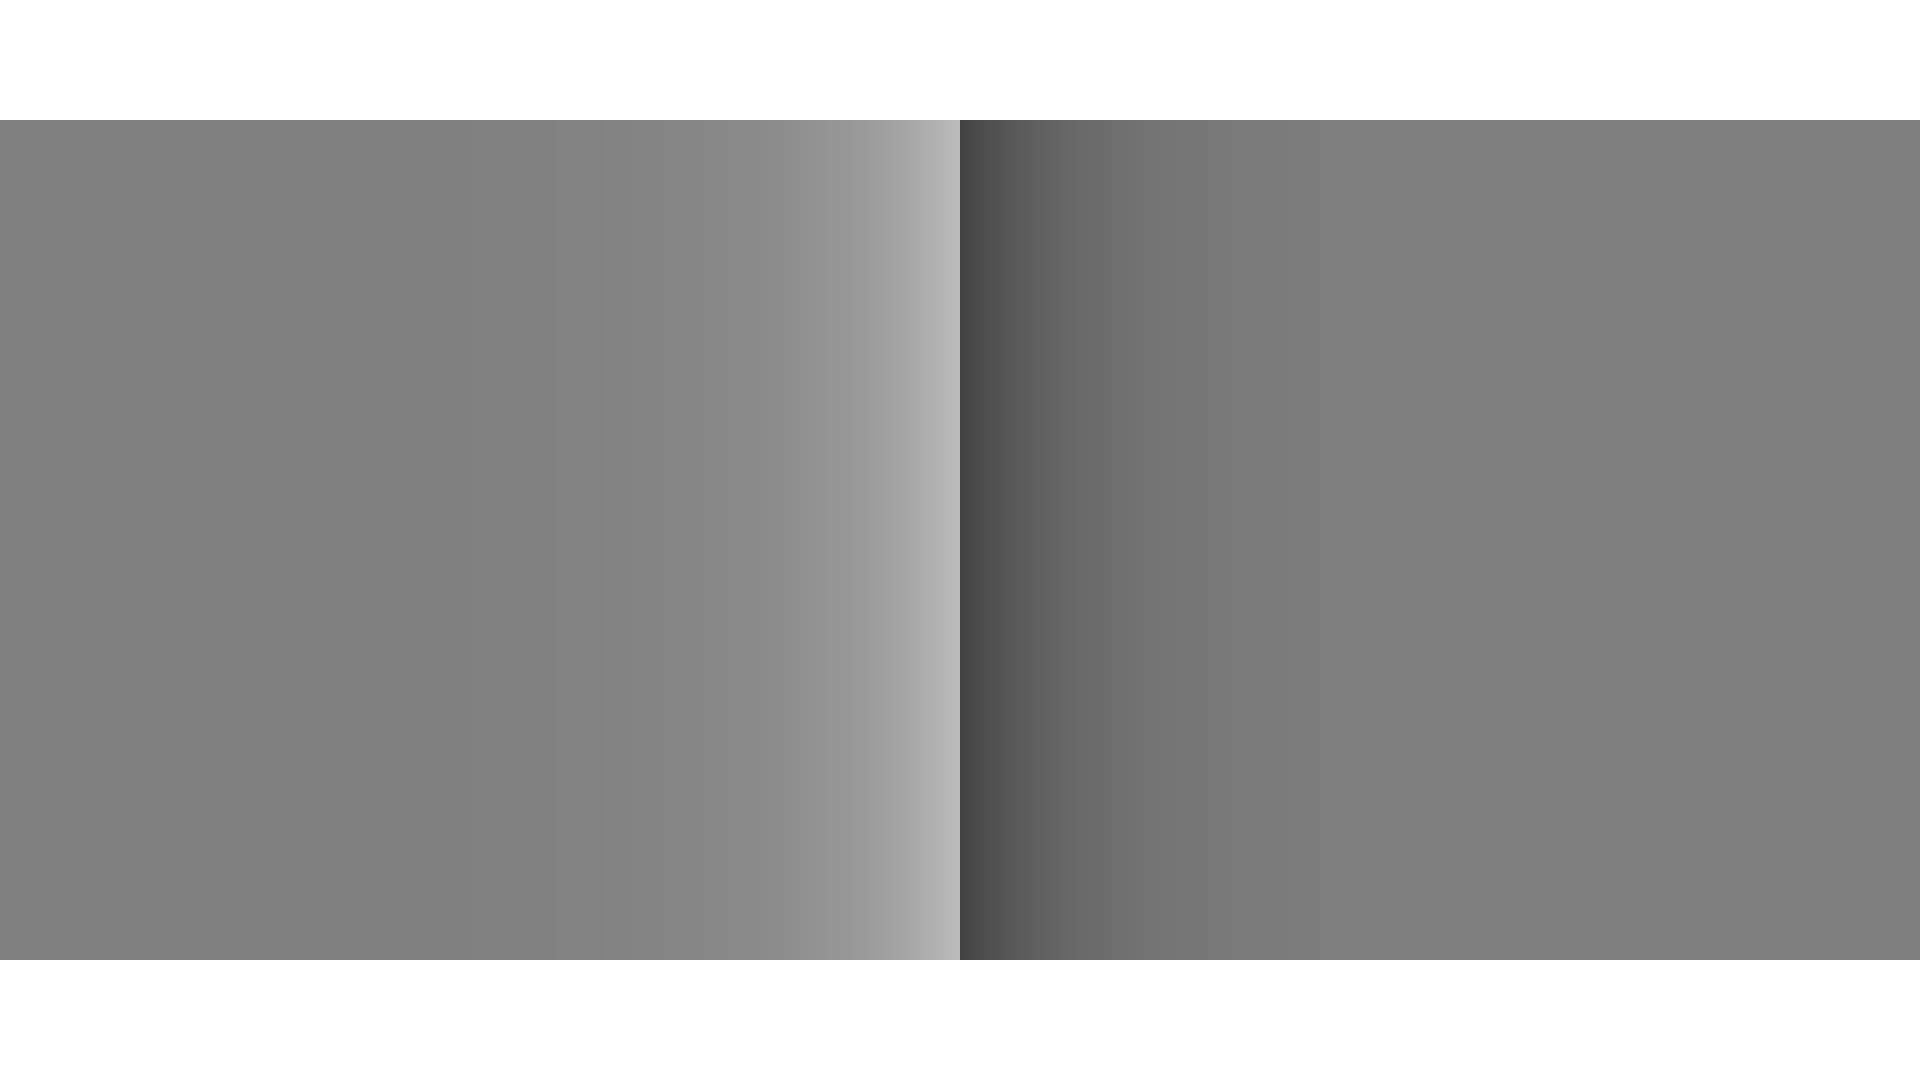
¿Cuál mitad es más clara? Ahora tapen la línea del medio con un dedo.
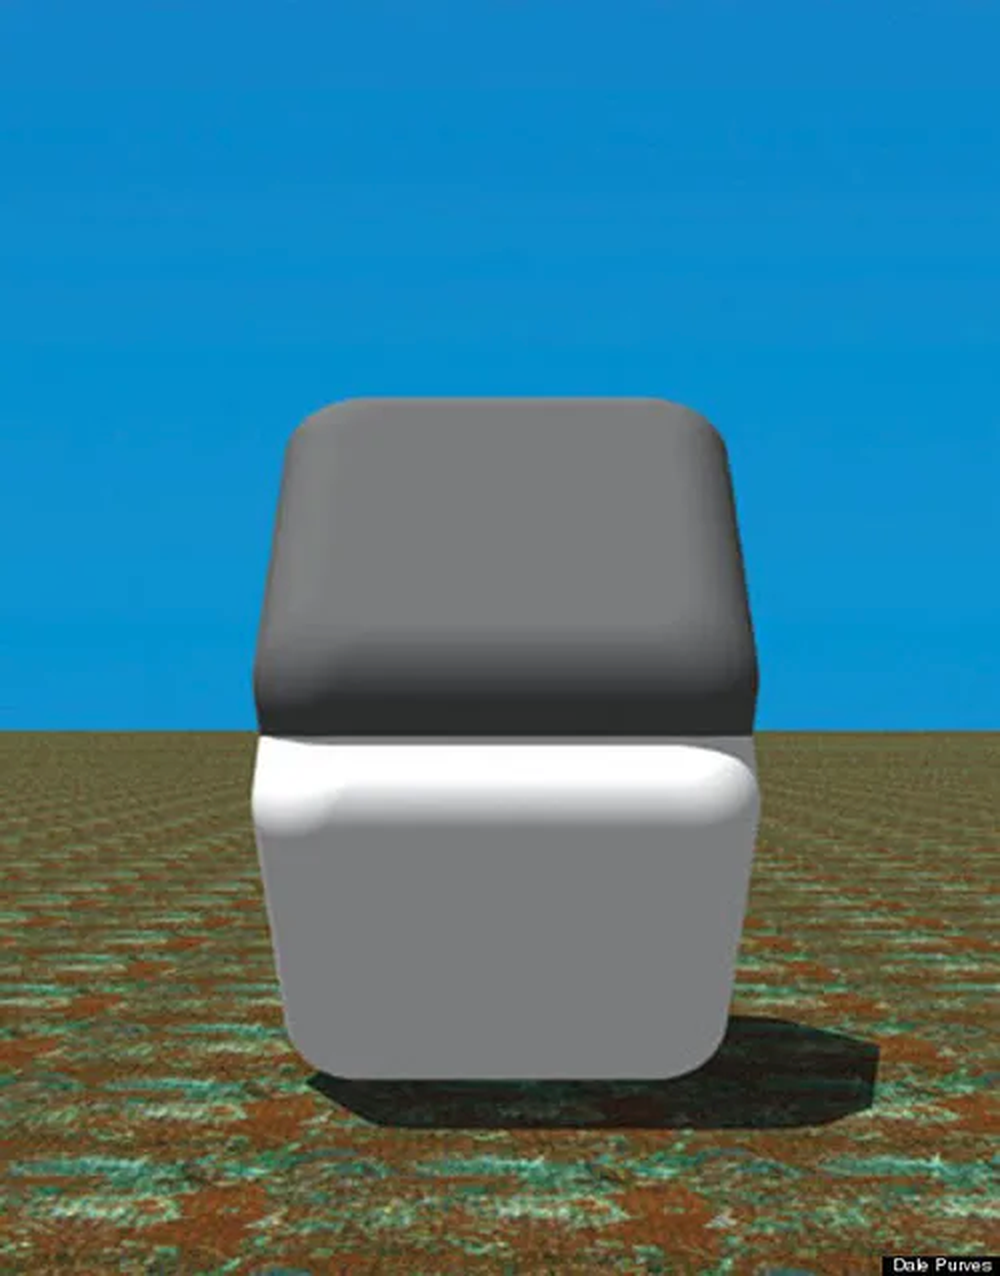
Lo mismo, con luz desde arriba
¿De qué color es cada mitad?
Ahora tapen con un dedo acostado la línea donde se juntan.
Imagen: Dale Purves. El efecto con iluminación y volumen: Purves, Shimpi y Lotto (1999).
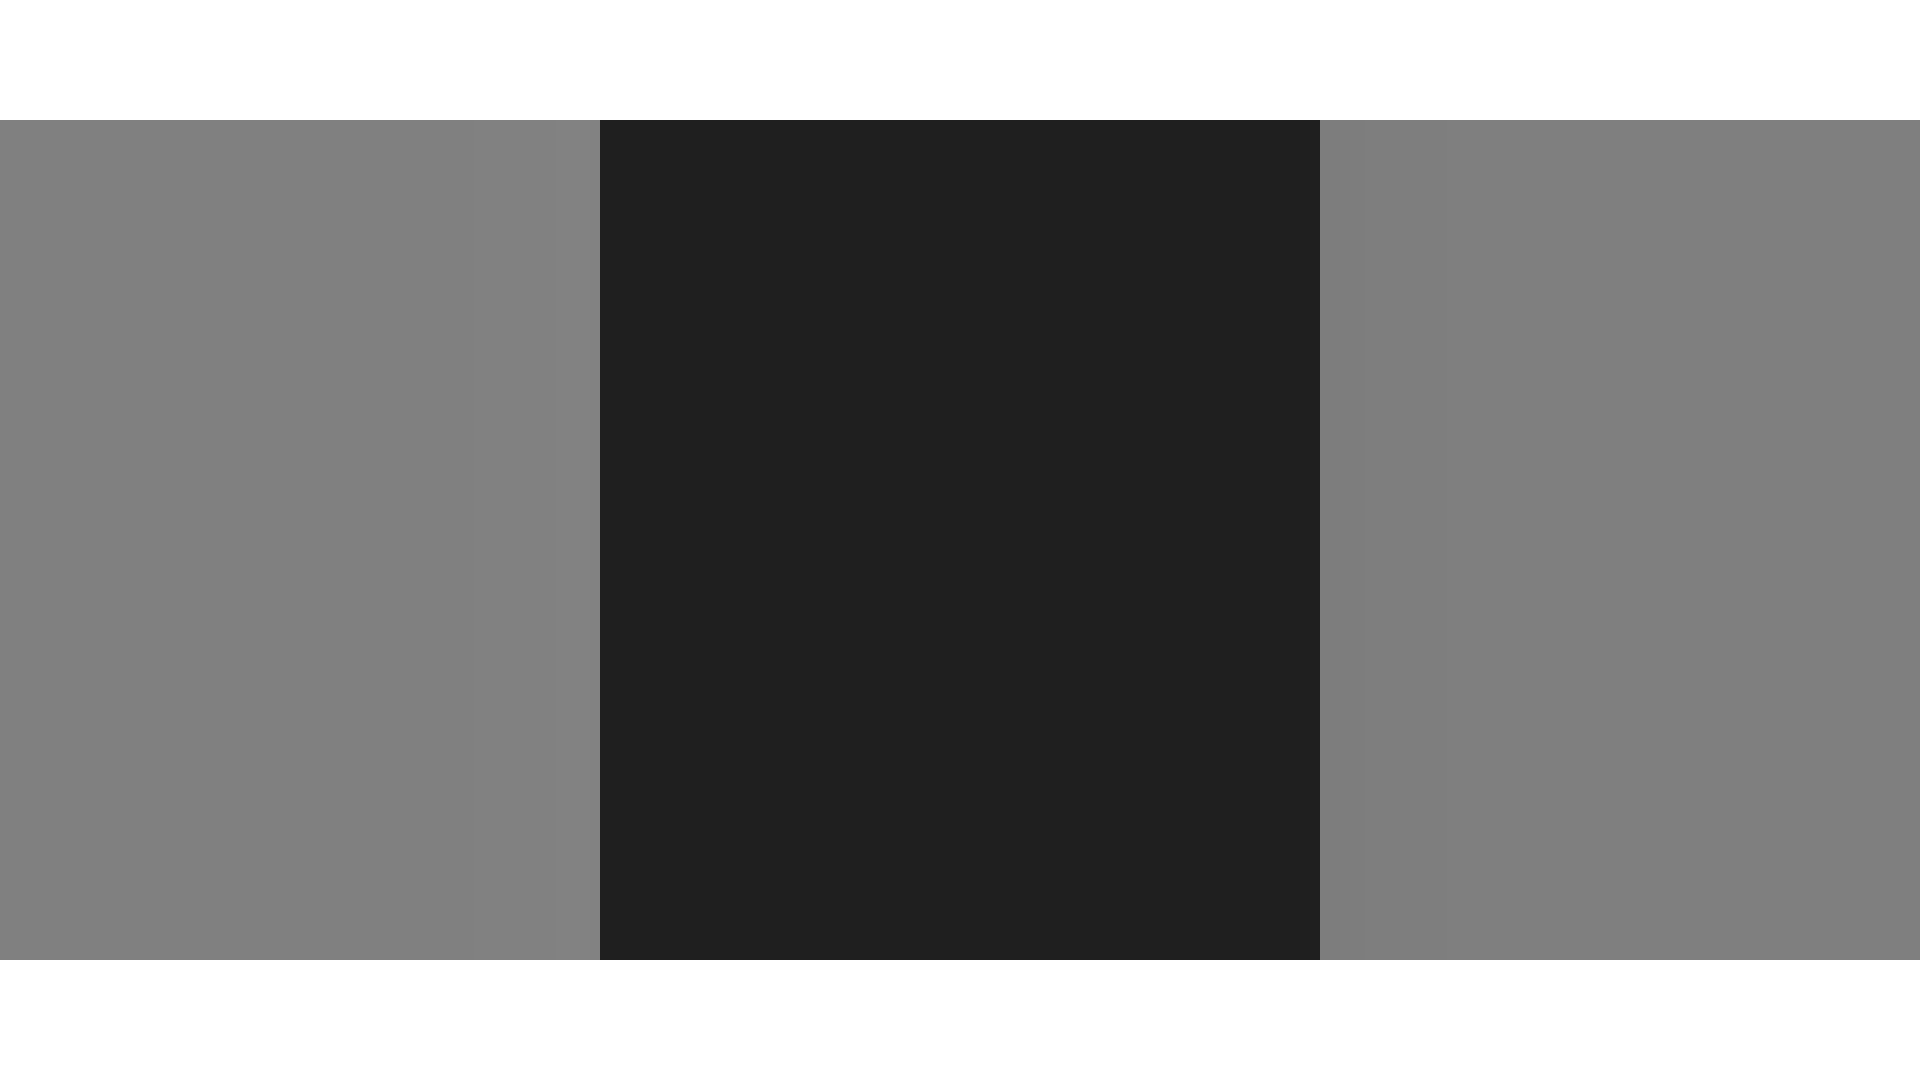
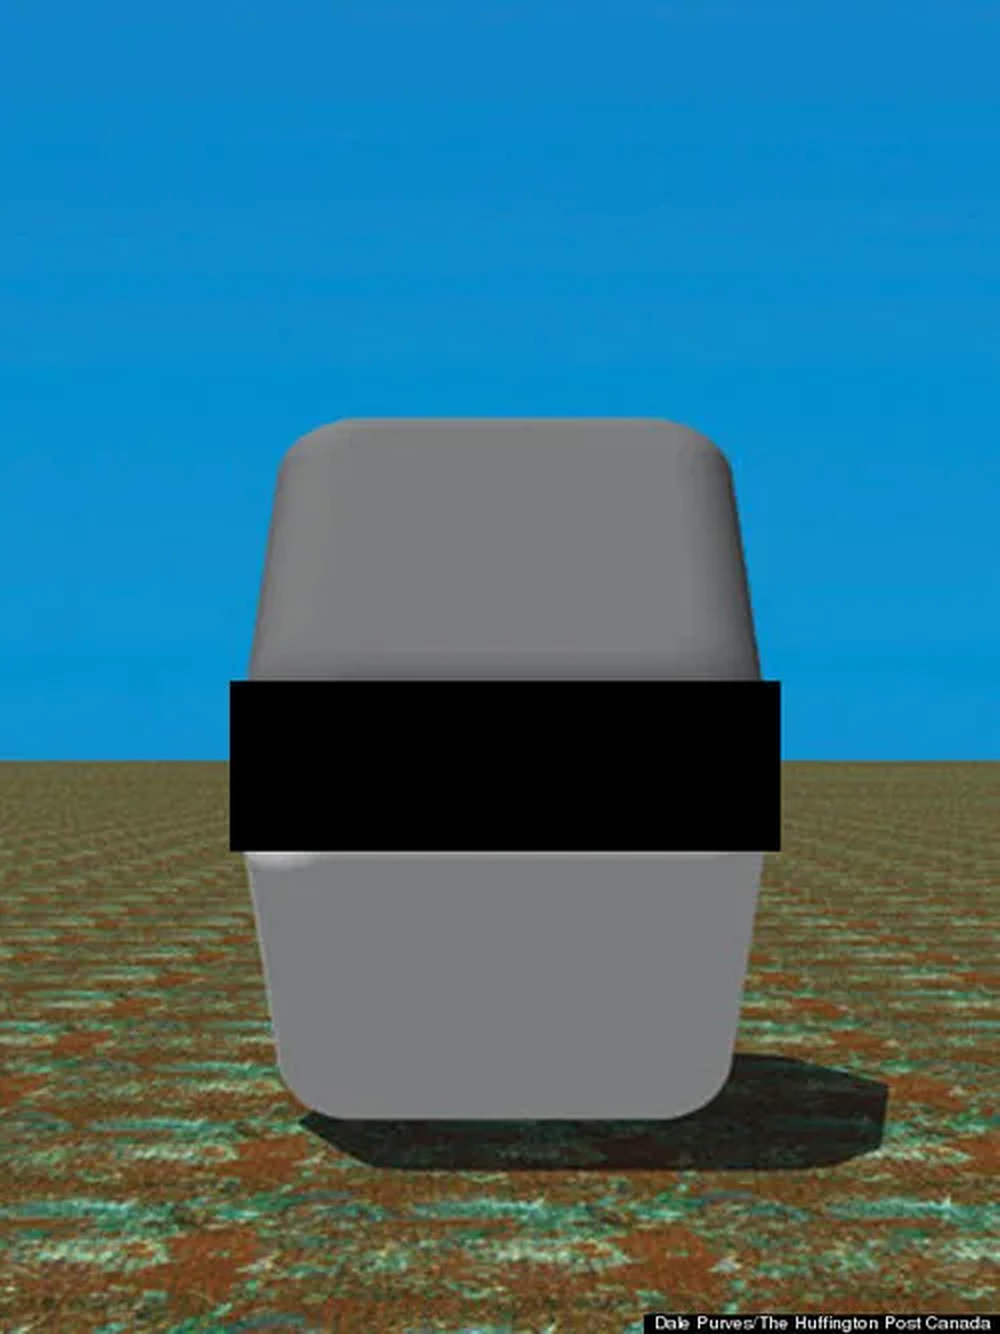
Con la unión tapada
El mismo gris
Sin la línea del medio, la diferencia se va. Saquen la franja y vuelve.
Imagen: Dale Purves. El efecto con iluminación y volumen: Purves, Shimpi y Lotto (1999).
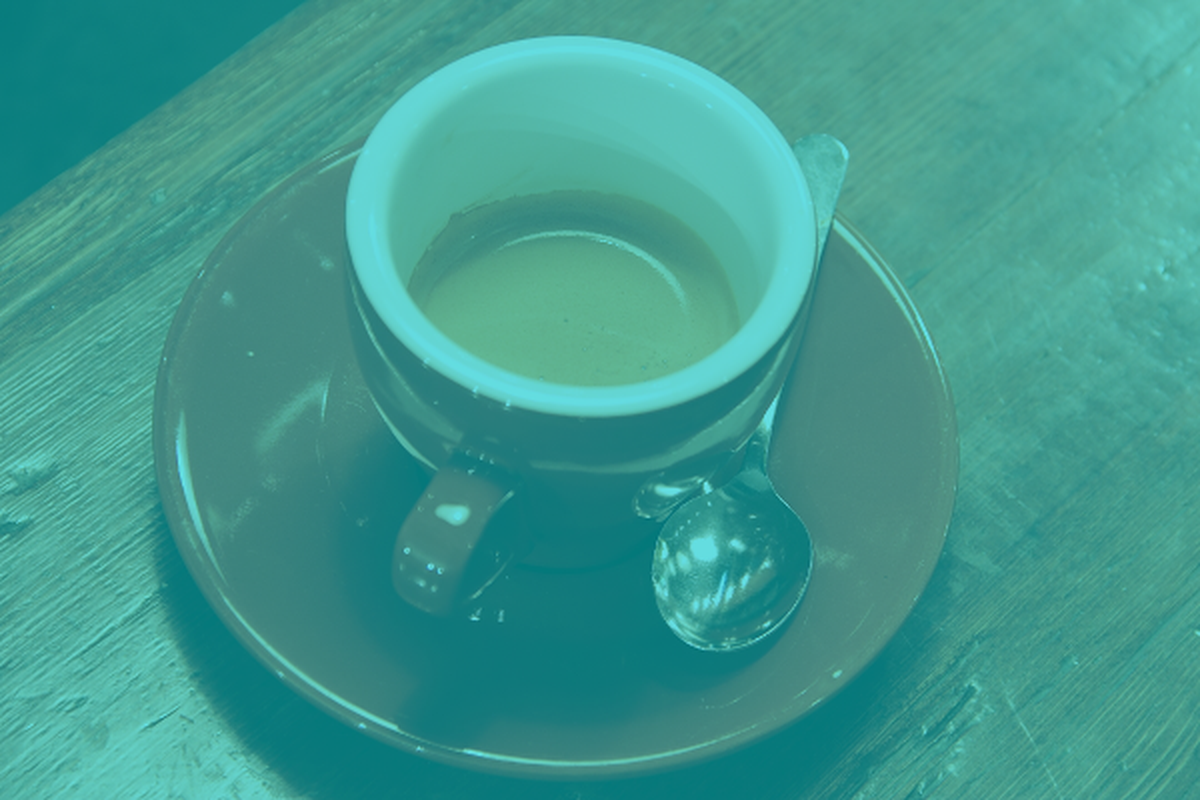
¿De qué color son el plato y la taza?
Elaboración propia sobre la foto CC0 de R. Michetti (scikit-image), con el método de las frutillas de Akiyoshi Kitaoka (2017).
Los mismos colores, fuera de la foto
Ni un píxel rojo
El plato
La taza
La mesa
El cerebro descuenta el color de la luz, como descontó la sombra del tablero.
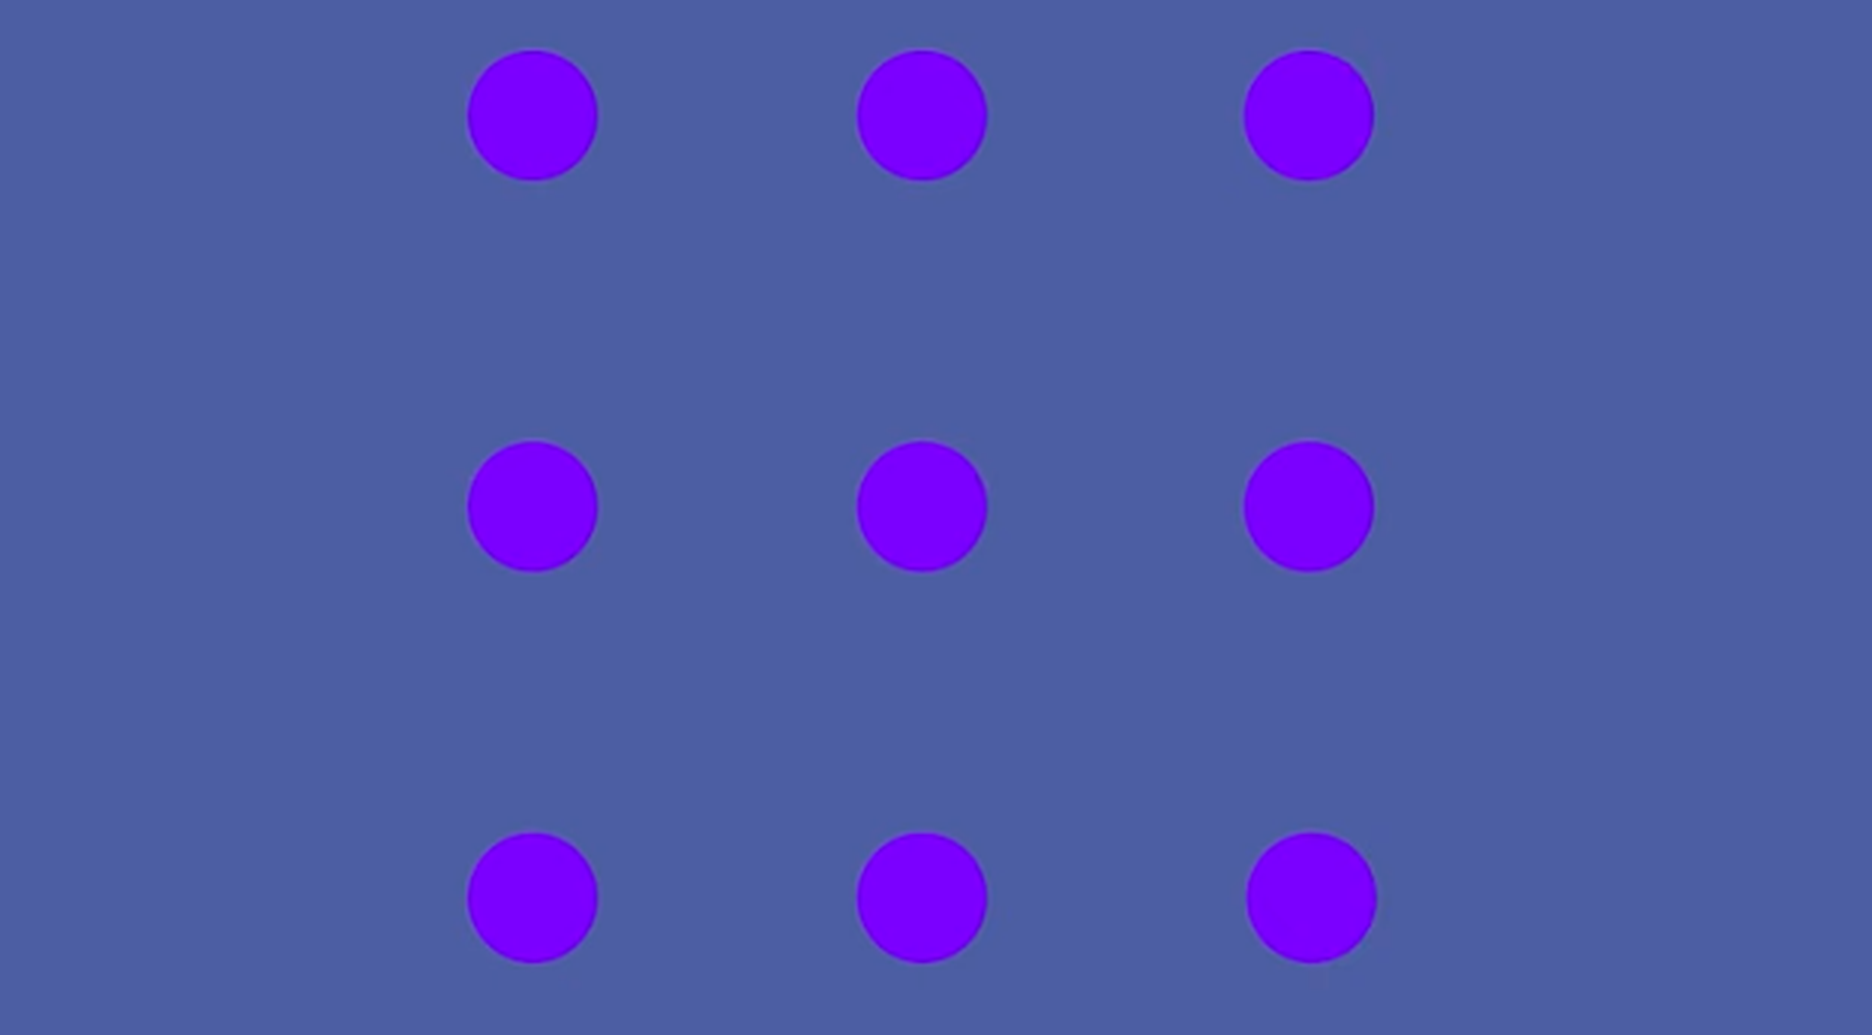
Miren fijo uno de los puntos. ¿De qué color es? ¿Y los de alrededor?
Hinnerk Schulz-Hildebrandt (Estados Unidos), “9 Purple Dots”. Segundo lugar, Best Illusion of the Year Contest, 2025.
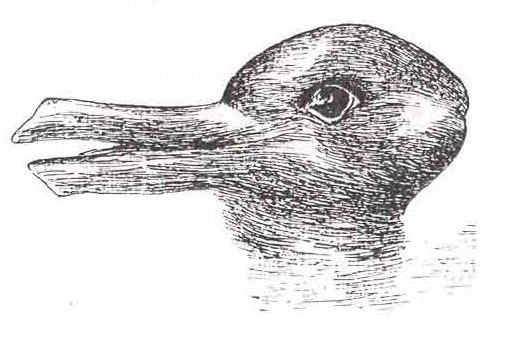
¿Qué animal ven? Piénsenlo sin decirlo.
El mismo truco, muchas versiones
¿Pueden pasar de uno a otro en todas?
La clásica
Jastrow (1899), a partir de “Fliegende Blätter” (1892). Dominio público.
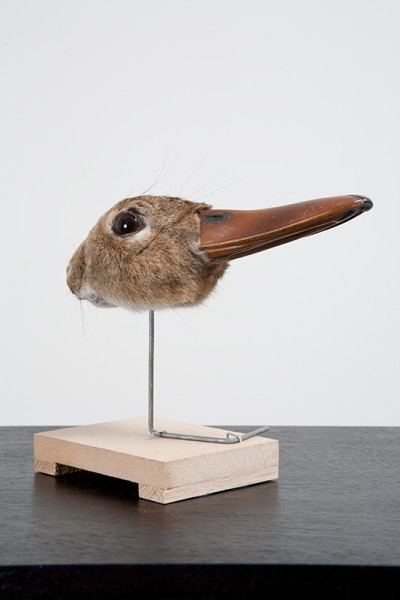
En tres dimensiones
Simon Cunningham, “Duckrabbit” (2008). Colección Hiscox.
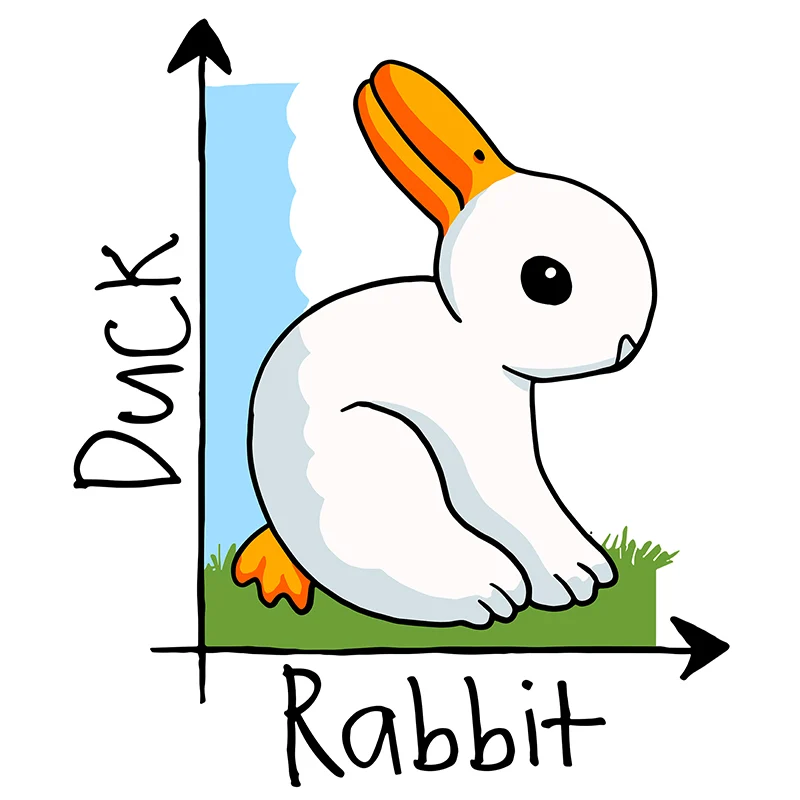
Según el eje
Diseño de Dina Prasetyawan en Artokingo (artokingo.co.uk).
Volvamos al tablero
La misma luz, dos apuestas
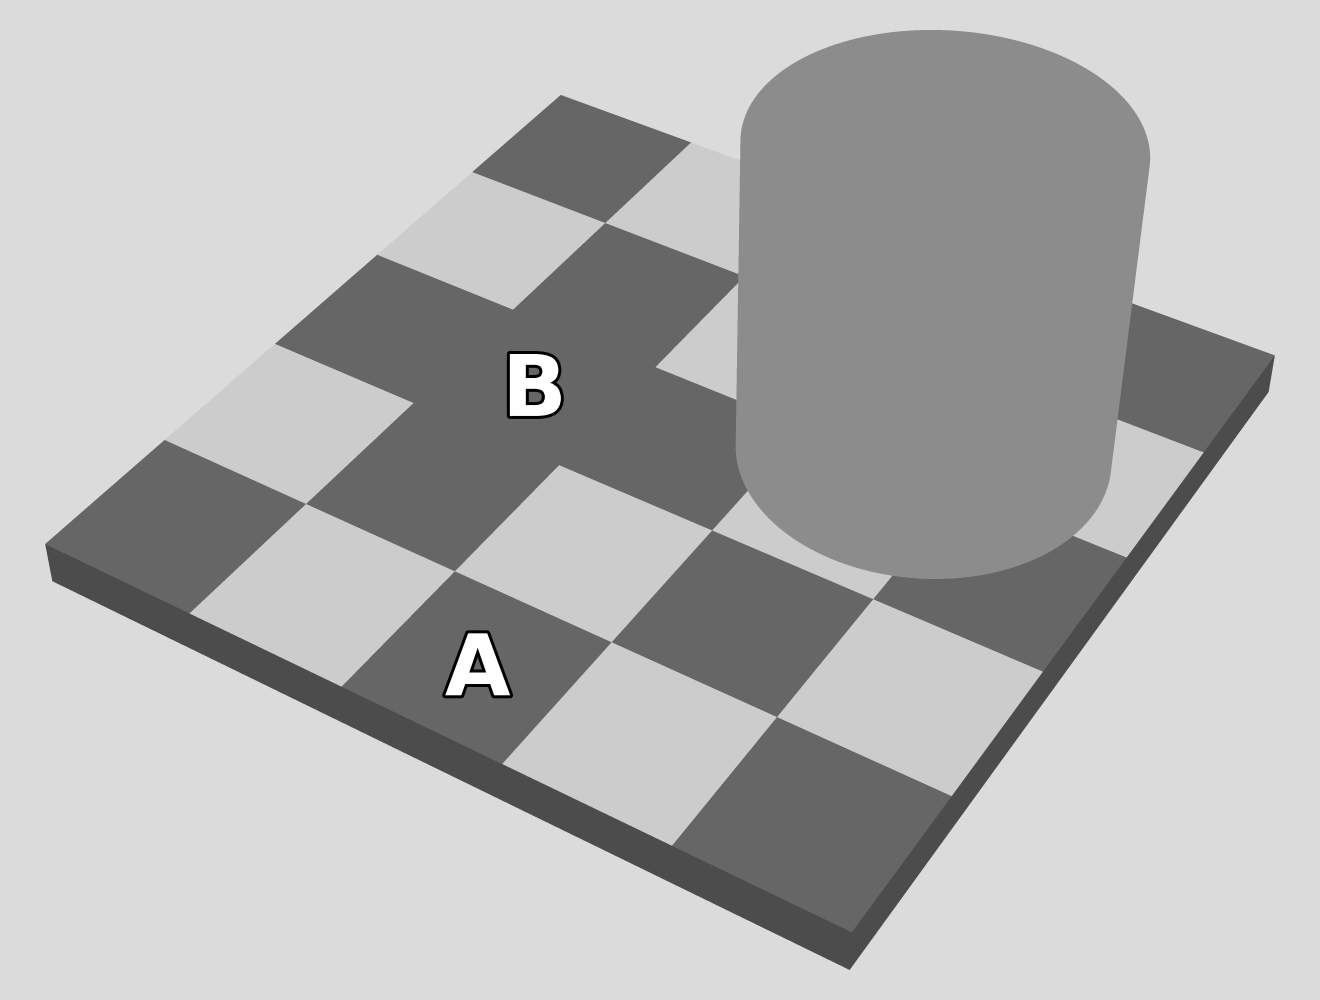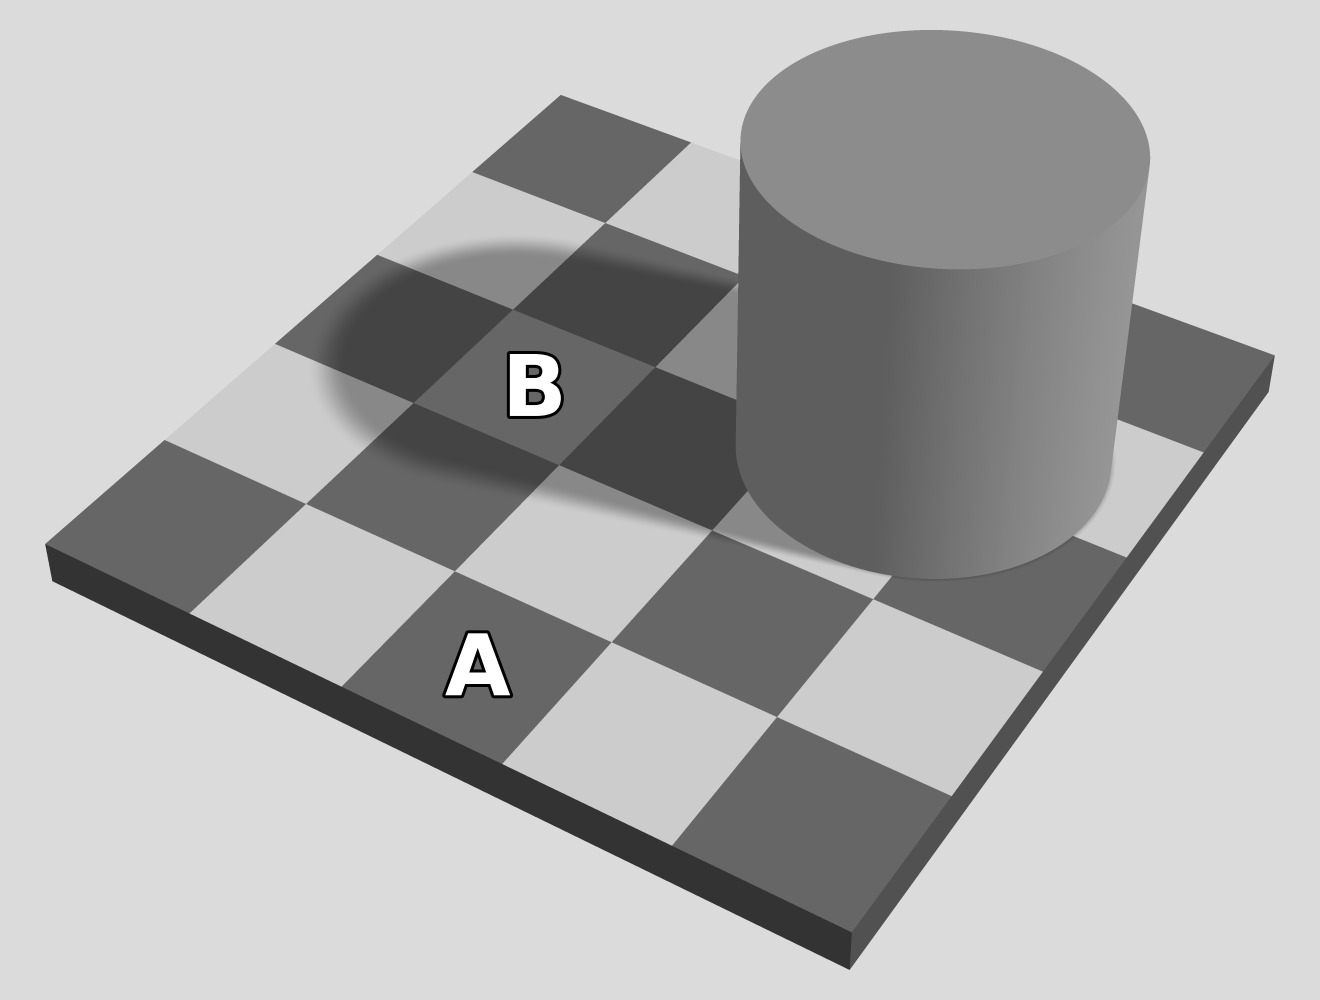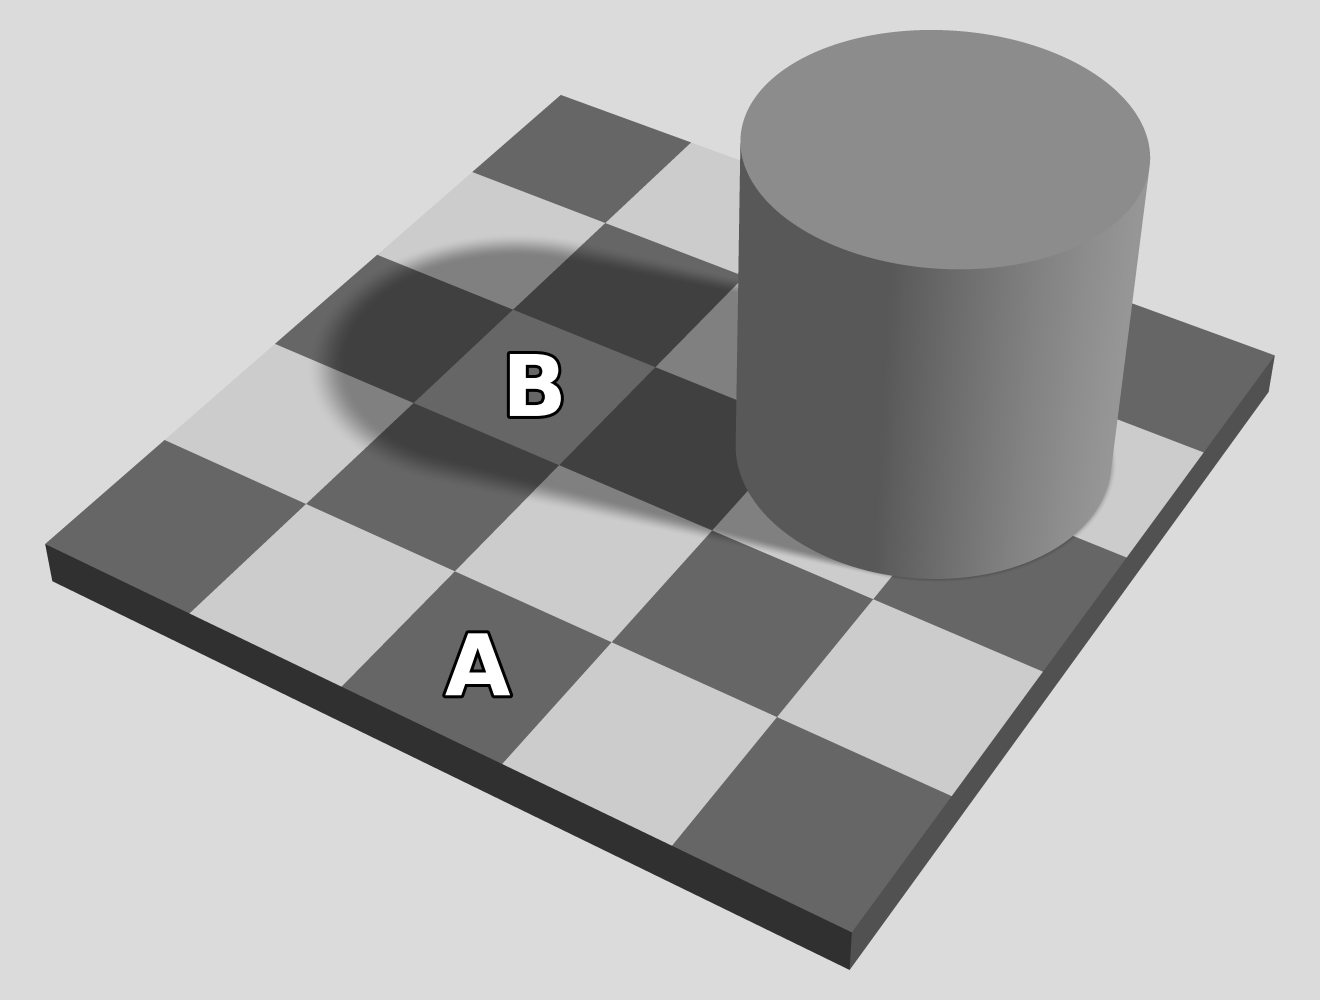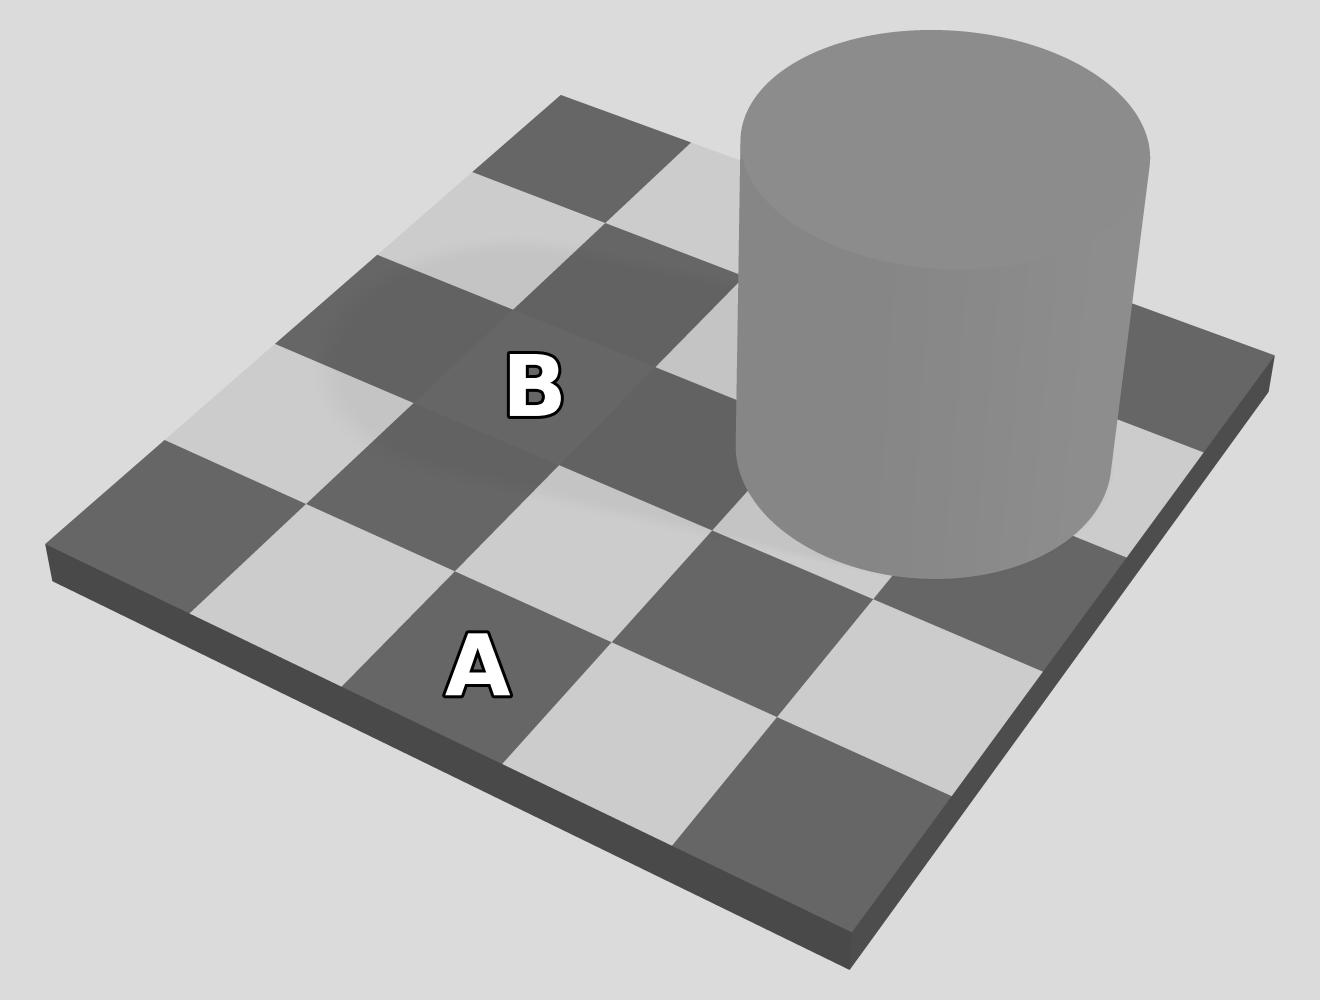
La sombra va y viene. A y B no cambian nunca.
Desde A y desde B llega al ojo la misma luz: 40 de cada 100.
A, a plena luz
Le llegan 100 y devuelve 40. El papel es oscuro: devuelve 40 de cada 100.
B, en la sombra
Le llegan 50 y devuelve 40. El papel es claro: devuelve 80 de cada 100.
No ven la luz que llega. Ven la apuesta sobre el papel.
Tablero propio, según el principio de Adelson (1995). Los números son los de la imagen: papel oscuro, 40 %; papel claro, 80 %; en la sombra, la mitad de la luz.
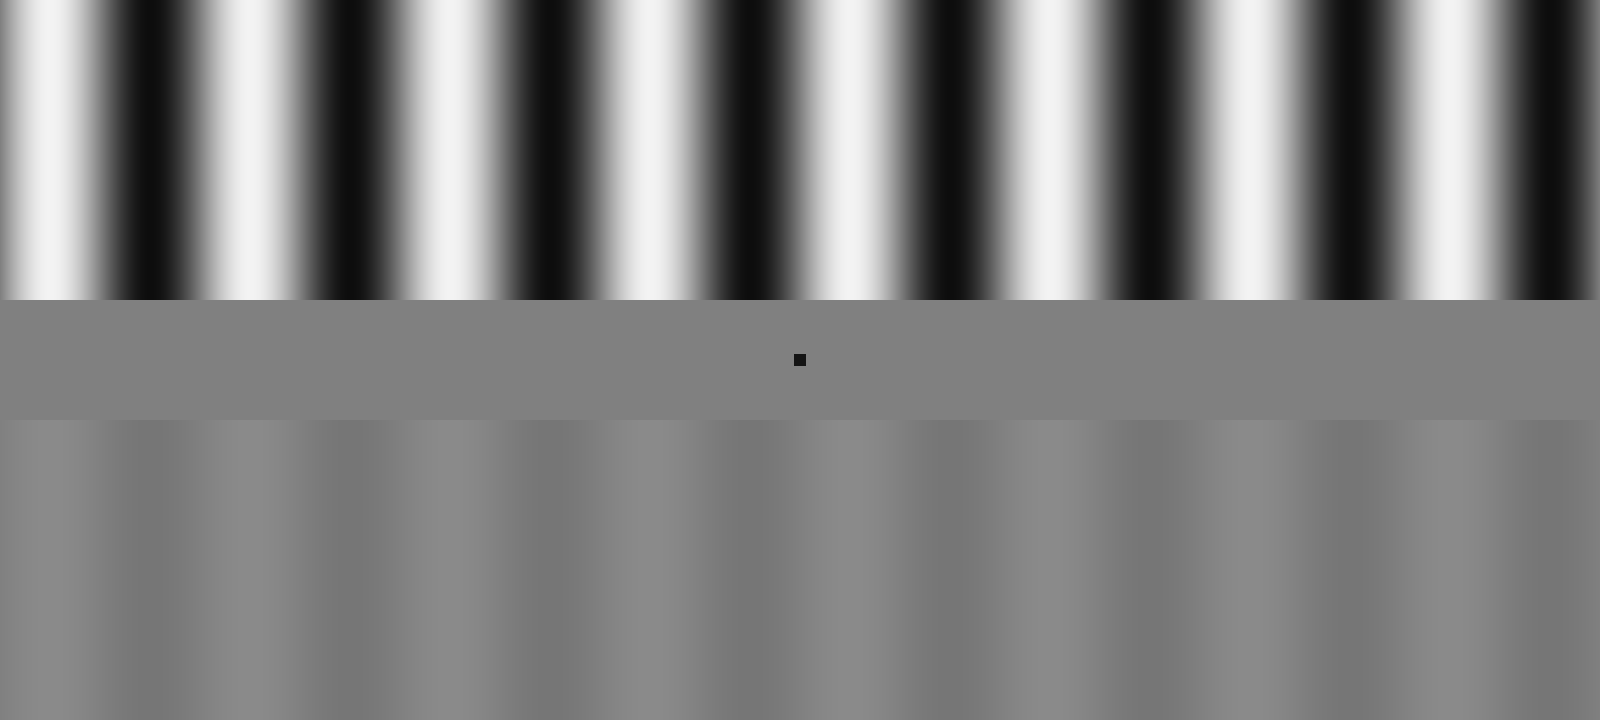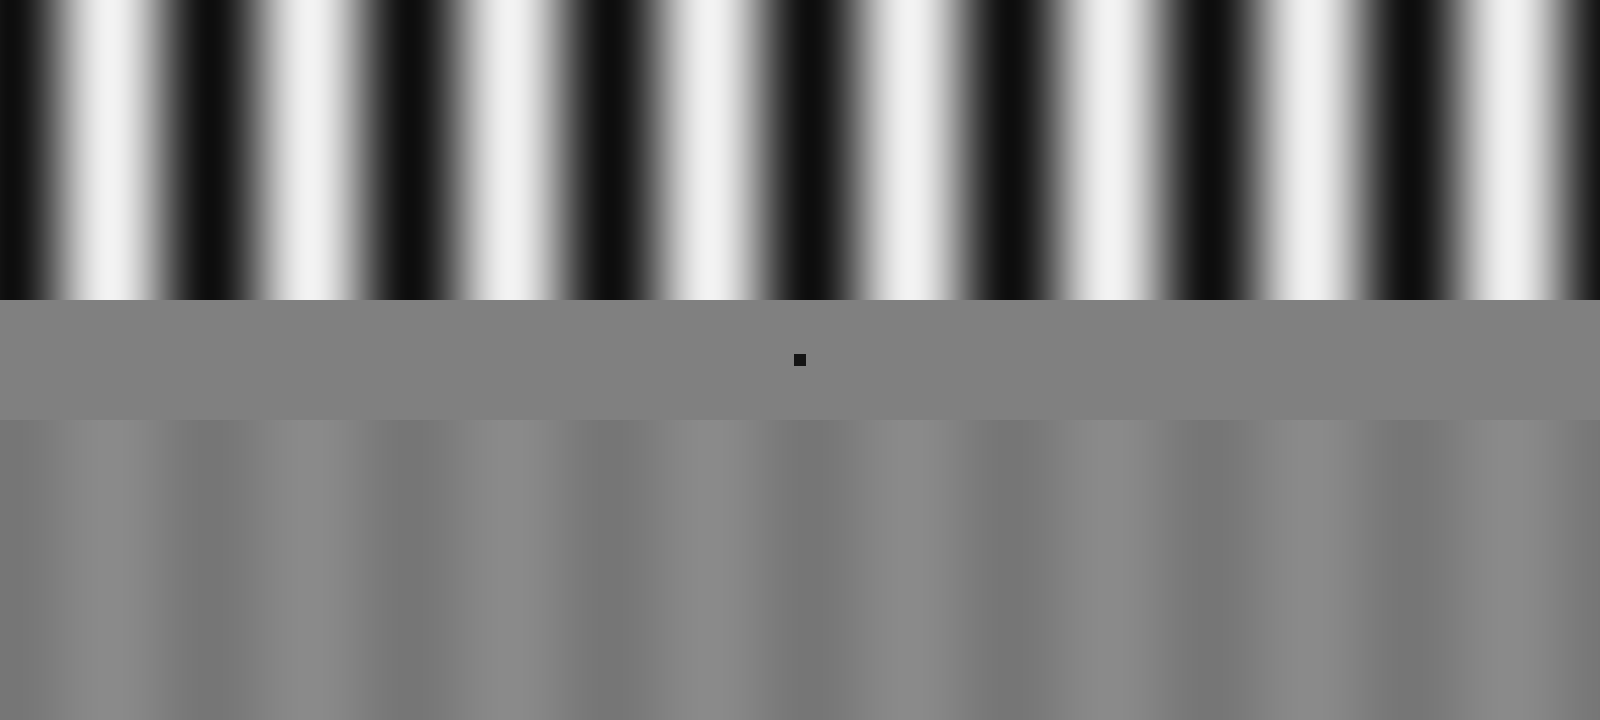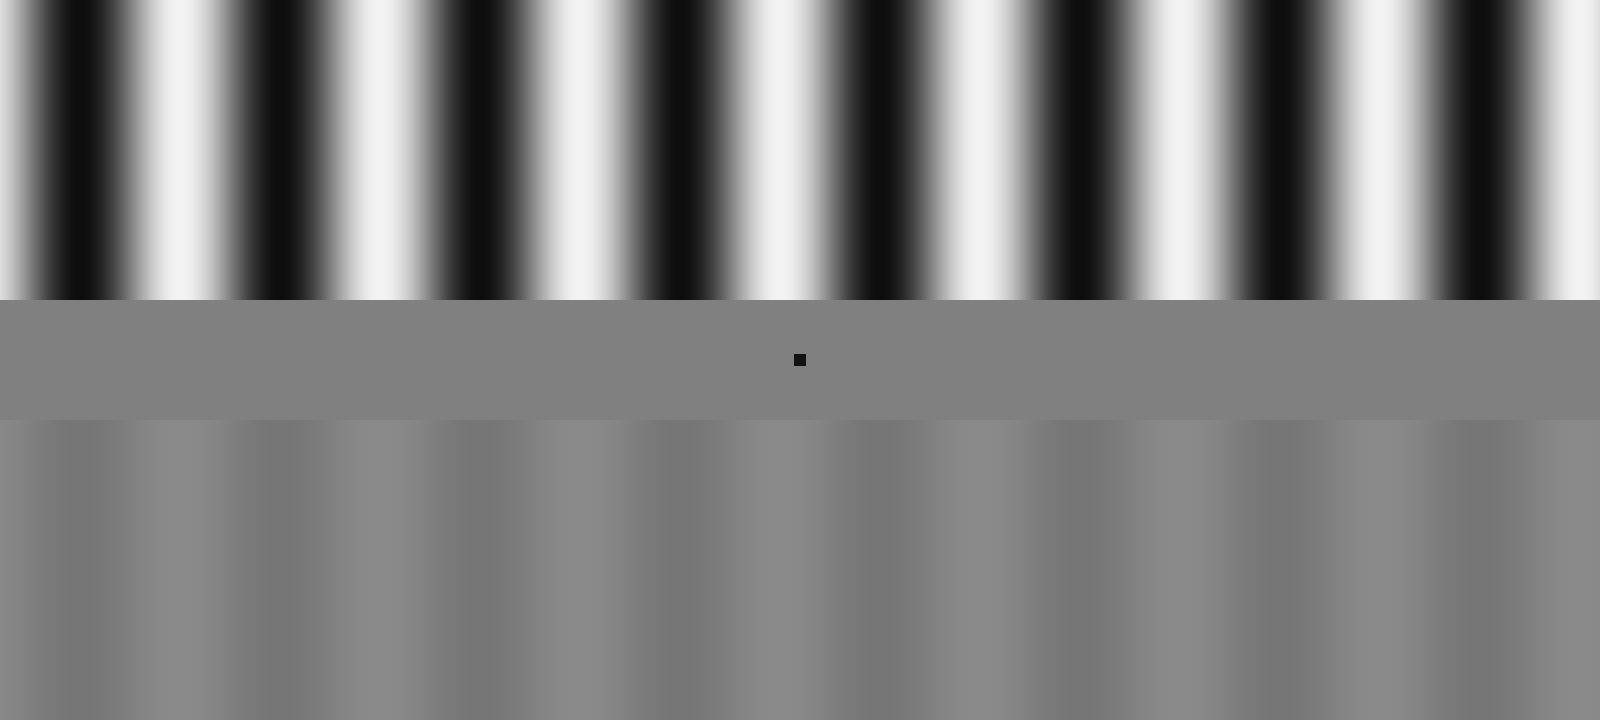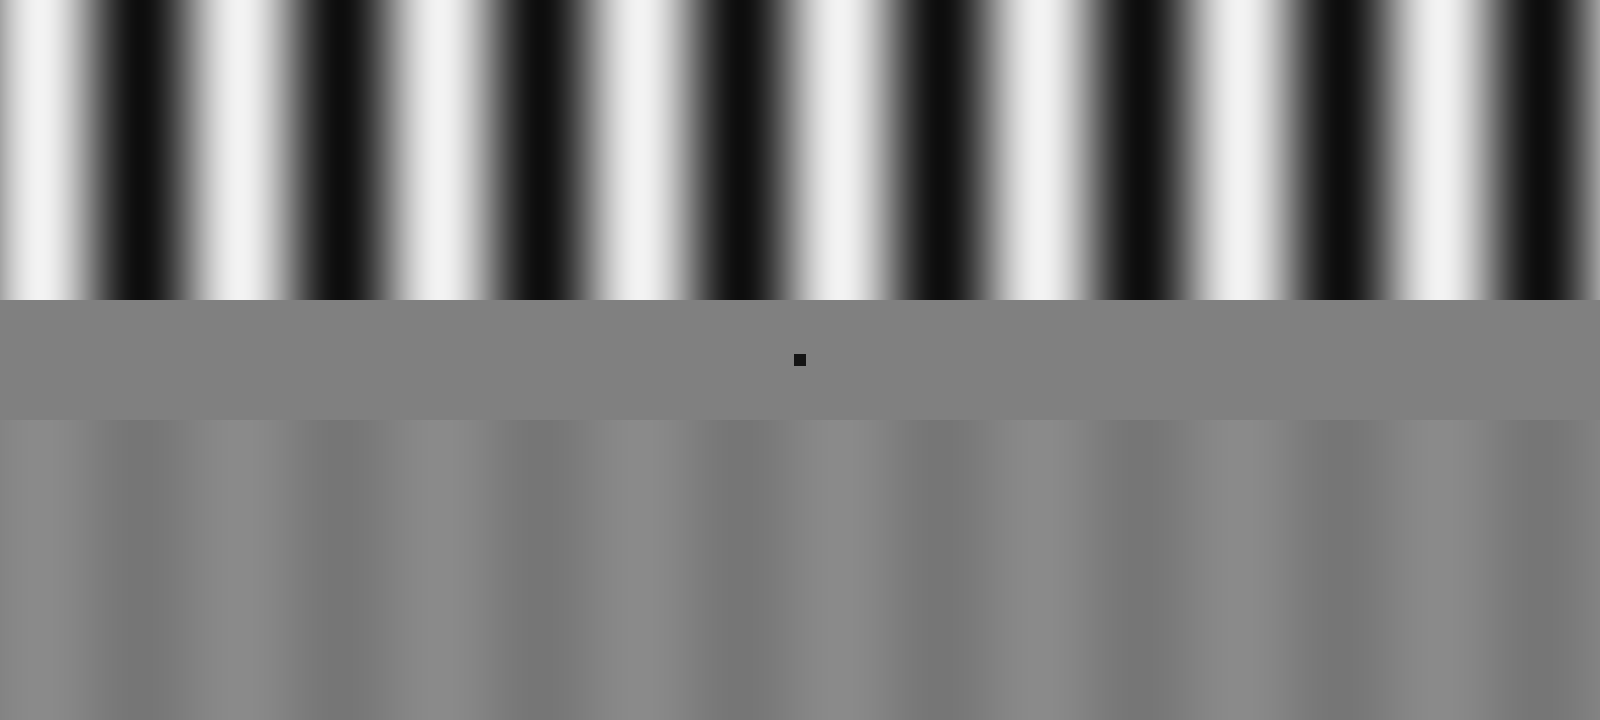
Miren el punto del centro. ¿Cuál va más rápido, la de arriba o la de abajo?
El efecto: Thompson (1982). La explicación como apuesta: Weiss, Simoncelli y Adelson (2002).
Los nombres
Percibir es apostar
En el tablero
En las franjas
Evidencia
Lo que llega a los ojos
40 de luz, desde A y desde B
Franjas nítidas arriba, apenas visibles abajo
Expectativa previa
Lo que suele pasar en el mundo
Las sombras quitan luz
Casi todo está quieto o va lento
Confiabilidad
Cuánto pesa cada una
La sombra se ve bien: pesa mucho
Con poco contraste, la evidencia pesa menos
La apuesta
Lo que vemos
B, más clara que A
La de abajo, más lenta
Mirando hacia atrás
Las apuestas que ya vieron
El lápiz en el agua
El cerebro apostó a que la luz venía en línea recta.
Las barras entre dos líneas
El cerebro apostó a que las líneas que se juntan se alejan.
El bloque gris
El cerebro apostó a que la luz venía de arriba.
Ver como apuesta lo comparten teorías distintas; una es el procesamiento predictivo.
Una idea con mil años
Ver es, en parte, inferir
El Cairo, hacia 1030
Ibn al-Haytham
“No todo lo que percibe el sentido de la vista se percibe por pura sensación; muchas propiedades visibles se perciben por juicio e inferencia.”
Matemático y físico; en Europa lo llamaron Alhacén.
Königsberg, 1781
Immanuel Kant
“El entendimiento no puede intuir nada; los sentidos no pueden pensar nada. Sólo de su unión puede surgir el conocimiento.”
Filósofo; “Crítica de la razón pura”.
Heidelberg, 1867
Hermann von Helmholtz
“En sus resultados se parecen a inferencias: desde el efecto observado en nuestros sentidos llegamos a una idea de la causa de ese efecto.”
Médico y físico; habla de lo que hace el cerebro, sin que lo notemos, al percibir.
Citas según Hohwy (2013, pp. 5, 17 y 39), en traducción propia desde el inglés: Ibn al-Haytham, “Óptica”, II.3.16; Kant, “Crítica de la razón pura”, A51/B75; Helmholtz, “Handbuch der physiologischen Optik” (1867), p. 430.
El problema
Si el cerebro "apuesta", y ustedes ya saben que las líneas son iguales,
¿por qué no corrige la apuesta?
Primera respuesta
La parte del cerebro que arma lo que ven trabaja rápido y por su cuenta: no escucha lo que saben.
Segunda respuesta
Sí escucha, pero una frase como “miden lo mismo” no cambia la apuesta en el momento. La cambia la experiencia de los sentidos, y eso toma tiempo.
Adams, Graf y Ernst (2004); Hohwy (2013, p. 127).
A mano alzada
¿Cuál les convence más?
La primera: no escucha lo que sabemos
La segunda: sólo la experiencia la cambia
Ninguna
A mano alzada
Un niño que nació con cataratas ve por primera vez, dos días después de operarse.
¿Cae en la Müller-Lyer?
Sí
No
Son nueve niños: una pista, no una prueba
Sí. Nueve niños de entre 8 y 16 años cayeron en la Müller-Lyer y en la Ponzo dentro de las 48 horas siguientes a su primera cirugía.
Gandhi et al. (2015).
Otro animal
¿Y un pez?
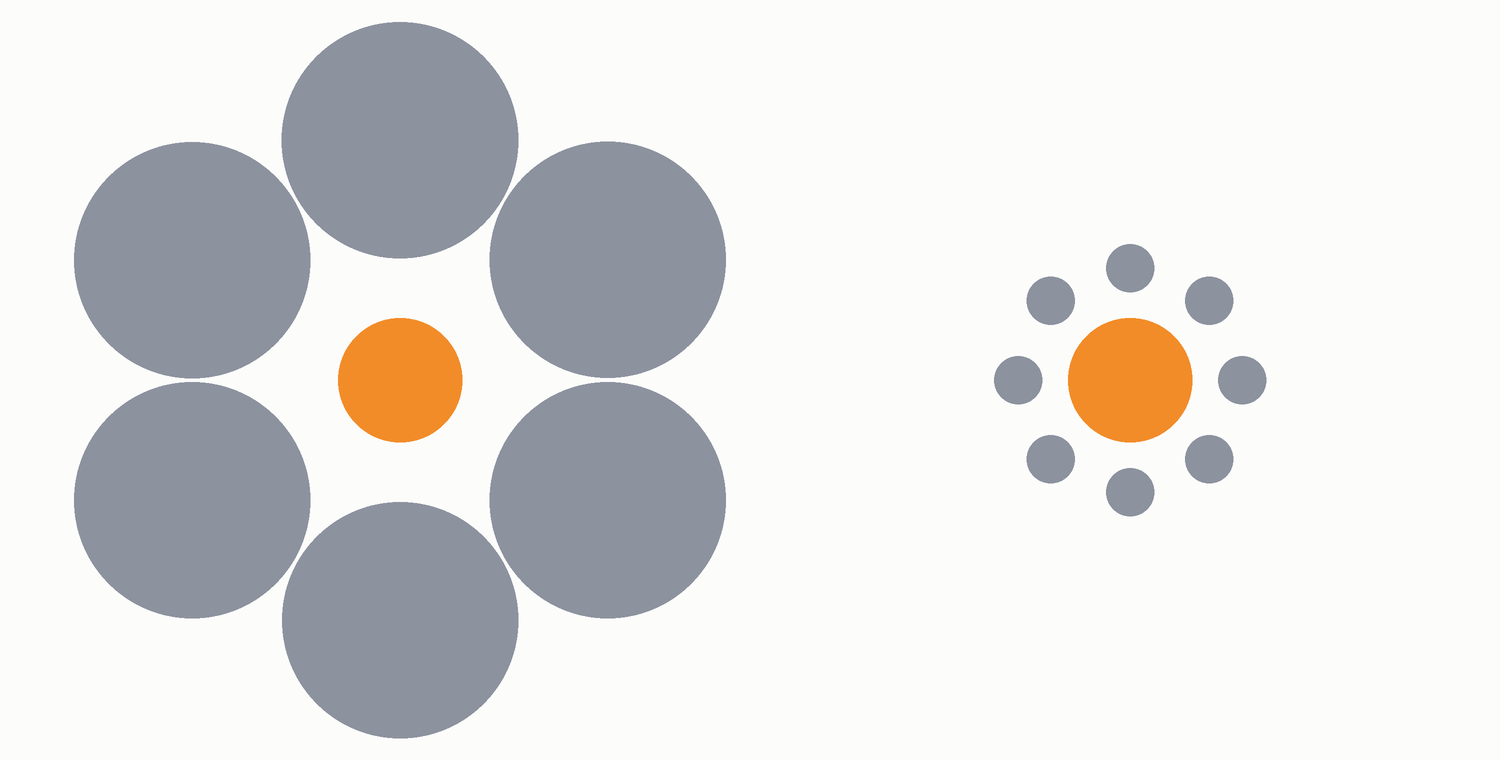
Los dos discos naranjos son del mismo tamaño.
A unos peces les enseñaron a ir al disco más grande para conseguir comida.
Con dos discos iguales, fueron al que a nosotros nos parece más grande.
Un pez no sabe que es una ilusión. Para equivocarse al ver no hace falta darse cuenta.
Sovrano, Albertazzi y Rosa Salva (2015), con el pez Xenotoca eiseni. La idea filosófica: Hacohen y Aizawa, “Error detection is not necessary for representation” (Mind & Language, en prensa).
¿De fábrica o aprendido?
Niños que ven por primera vez, y un pez, caen en la ilusión. Lo que hace esa “apuesta”, ¿viene de fábrica o se aprende?
Una discusión de más de dos mil años
Dos respuestas viejas
Venimos con ideas de fábrica
Platón, Descartes, Leibniz. Hoy, algunos sostienen que conceptos como objeto, agente, número o causa son innatos.
Todo entra por la experiencia
Locke: la mente empieza como “papel en blanco”. Hume: cada idea simple viene de una impresión de los sentidos.
Locke, Ensayo sobre el entendimiento humano (1690), II.1.2; Hume, Tratado de la naturaleza humana (1739), I.1.1; Carey (2009).
La pregunta de Molyneux
¿Reconocería con los ojos lo que conocía con las manos?
1688
William Molyneux le pregunta a Locke: alguien ciego de nacimiento que distingue un cubo de una esfera al tocarlos, si empieza a ver, ¿los reconocerá sólo mirándolos? Locke responde que no.
2011
Cinco jóvenes de entre 8 y 17 años, del mismo proyecto que los niños de la Müller-Lyer, recién operados: no lograron emparejar lo que veían con lo que habían tocado. A los pocos días, sí.
Locke, Ensayo, II.9.8 (2.ª ed., 1694); Held et al. (2011), Nature Neuroscience 14, 551-553; Gandhi et al. (2015).
Un experimento con la vieja pregunta
Las redes neuronales no traen ideas, pero tampoco parten de cero
Lo que no traen
Ninguna idea de gato, taza o número. Aprenden de muchísimos ejemplos: ImageNet, la base con que se entrenan muchas, tiene 14 millones de fotos con etiqueta.
Lo que sí traen
Facultades generales, como mirar por partes, recordar, imaginar y atender. Sin memoria ni atención, nadie aprende nada de ninguna cantidad de experiencia.
Buckner (2019, pp. 11-12; 2023, cap. 1): empirismo moderado. La frase sobre memoria y atención resume a Laurence y Margolis (2015), citados por Buckner.
Mirar por partes
Nadie le dio estos detectores: los aprendió de las fotos
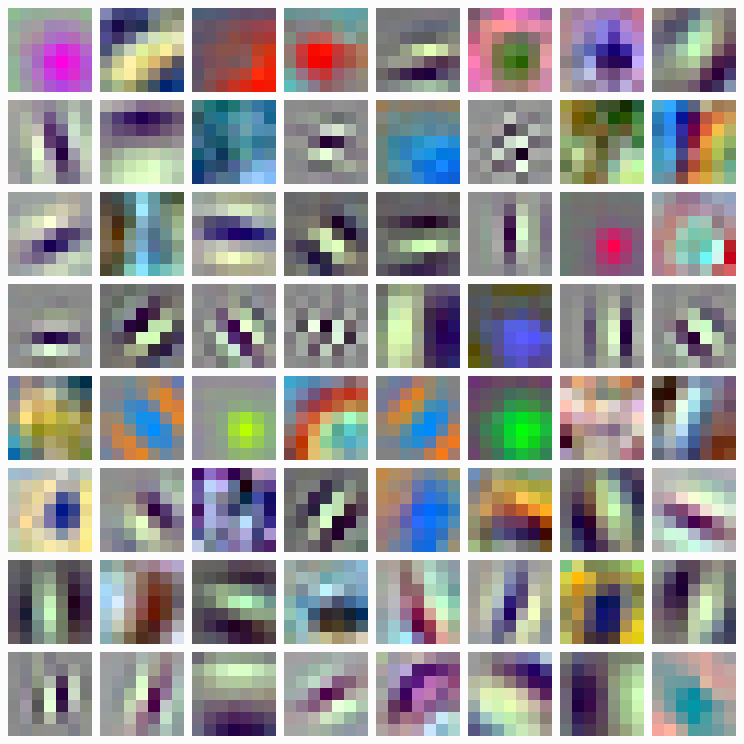
Los 64 detectores de la primera capa de una red que clasifica fotos
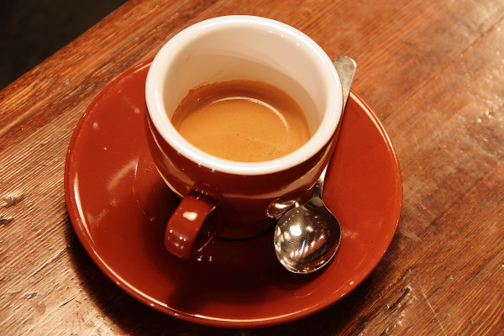
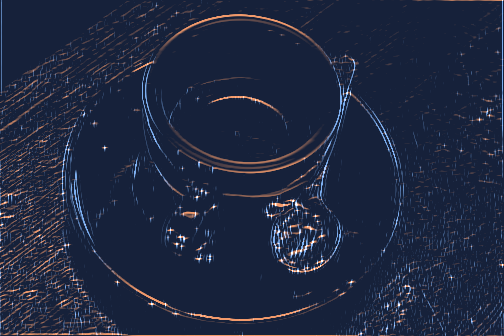
Cada detector recorre toda la foto. Dos de ellos sobre la taza: bordes horizontales (naranjo) y verticales (azul).
Las capas siguientes combinan bordes en formas, y formas en objetos.
Elaboración propia: filtros de la primera capa de ResNet-50 (pesos del ONNX Model Zoo) y su respuesta sobre la foto de R. Michetti (CC0). Como Buckner (2018), que muestra un filtro de bordes sobre una pintura; Hubel y Wiesel (1962).
Una facultad, un filósofo, una arquitectura
Cada tipo de red imita una facultad
| Facultad | Filósofo o filósofa | Tipo de red |
|---|---|---|
| Percepción | John Locke | Redes convolucionales, como la de la taza |
| Memoria | Ibn Sina | Redes que vuelven a repasar sus experiencias |
| Imaginación | David Hume | Redes generativas, que inventan imágenes nuevas |
| Atención | William James | Transformers, el motor de los chatbots |
| Cognición social | Sophie de Grouchy | Redes que modelan lo que otros creen |
Buckner, From Deep Learning to Rational Machines (Oxford University Press, 2023), caps. 3 a 7.
Lo que muestran
¿Le dan la razón a Locke?
En parte, sí
Locke preguntaba cómo sale la idea de triángulo de triángulos que son todos distintos. Capa a capa, estas redes aprenden a dejar de lado lo que no importa, sin ideas de fábrica.
Pero aprenden distinto
Necesitan muchísimos ejemplos. Aunque un bebé que juega diez minutos con un juguete quizá recibe decenas de miles de vistas.
Y se equivocan distinto
Pueden captar cómo se ve algo sin distinguir lo que realmente es. Es lo que viene ahora.
Locke (1690), IV.7.9; Buckner (2018; 2019, pp. 12-14; 2023, cap. 1 y epílogo).
Acto 3
“La IA” no es una sola cosa
Red de video
Aprende a predecir el siguiente cuadro de un video.
Clasificador
Un programa que pone una etiqueta a cada foto.
Chatbots
Miran imágenes y responden: ChatGPT, Gemini, Claude.
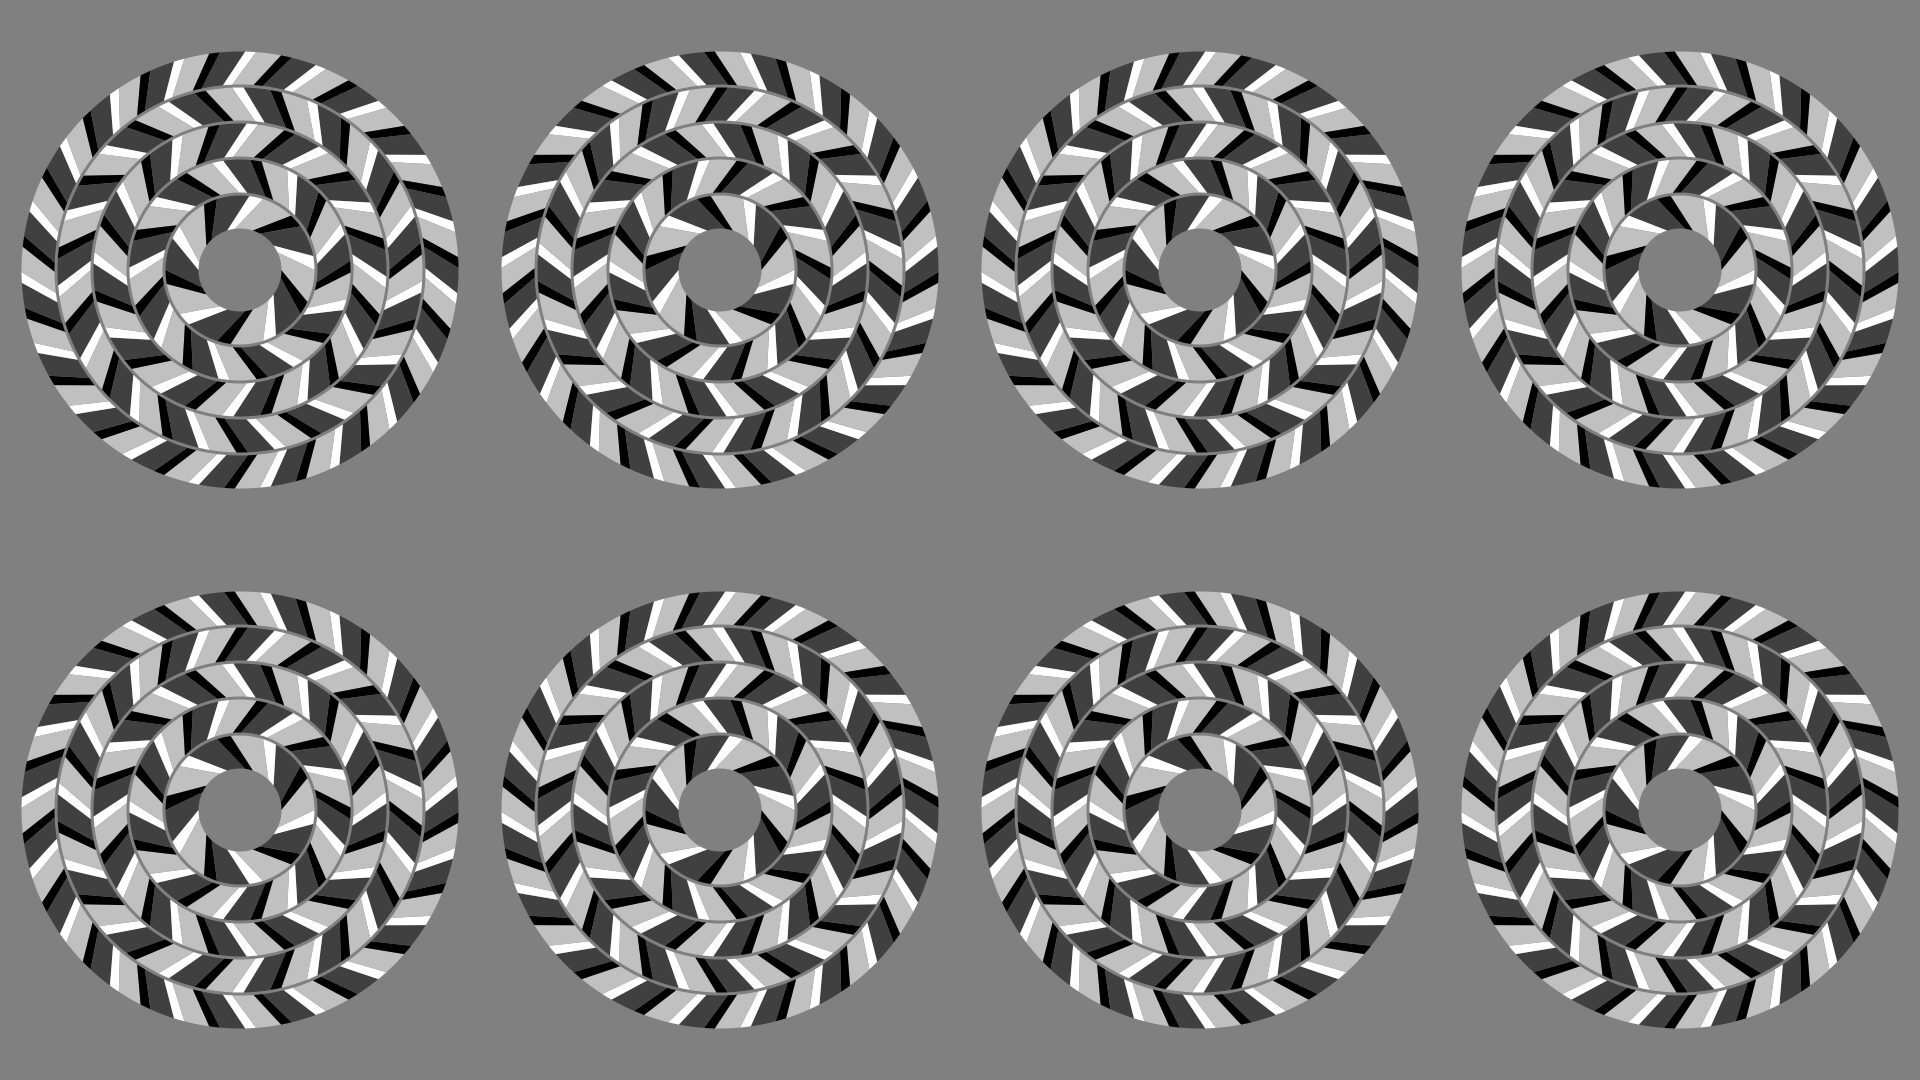
Una red que aprendió a predecir video “vio” girar imágenes como las de la izquierda
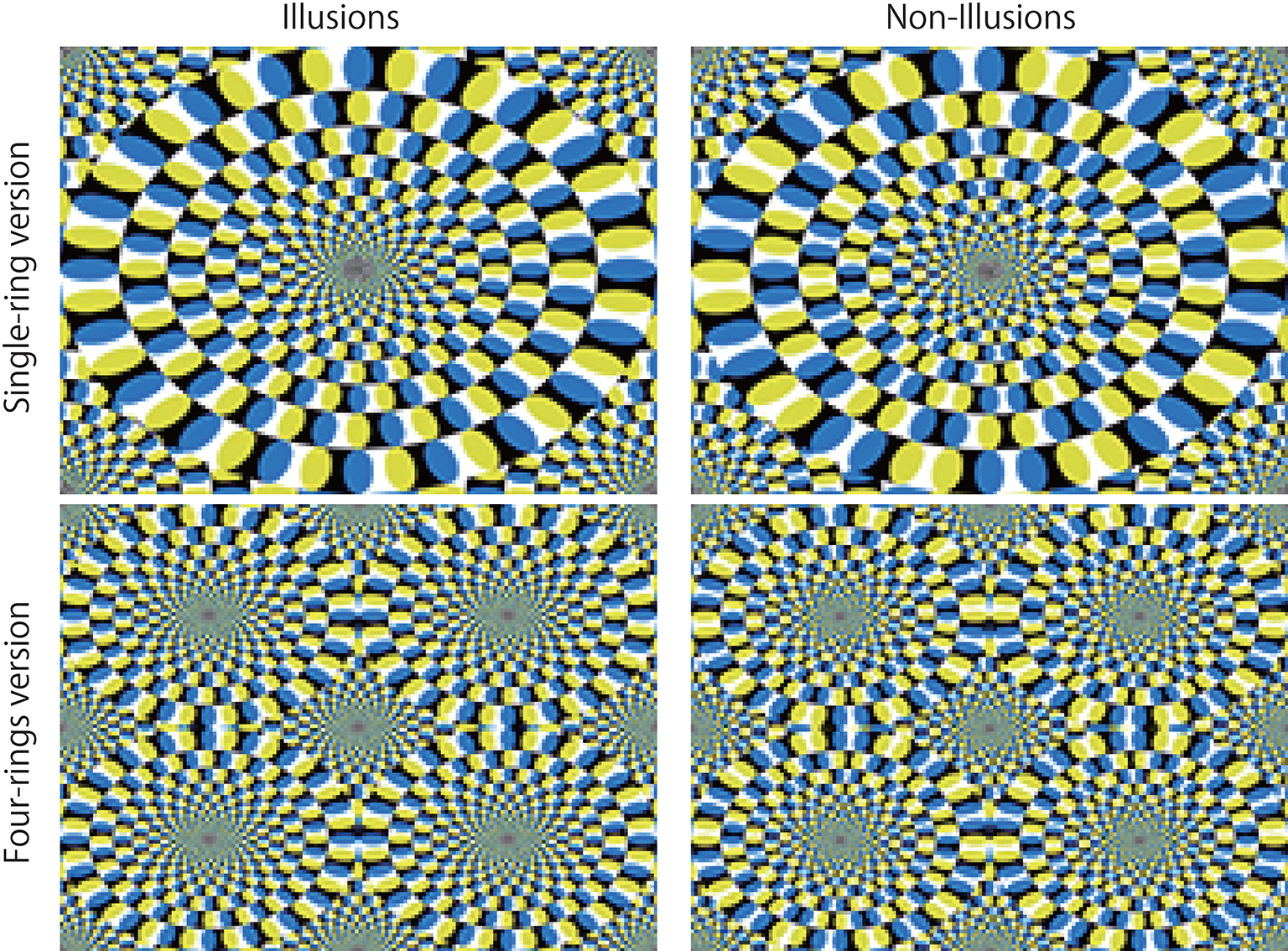
Watanabe, Kitaoka, Sakamoto, Yasugi y Tanaka (2018), Frontiers in Psychology 9, 345, fig. 2, CC BY 4.0.
Diez copias idénticas de esa red
4 de 10
la vieron girar en la versión a color
0 de 10
en una versión en grises, que las personas sí ven girar
La que ustedes acaban de ver es en grises.
Watanabe et al. (2018); Kirubeswaran y Storrs (2023).
Una ilusión de máquina
Tienen las suyas
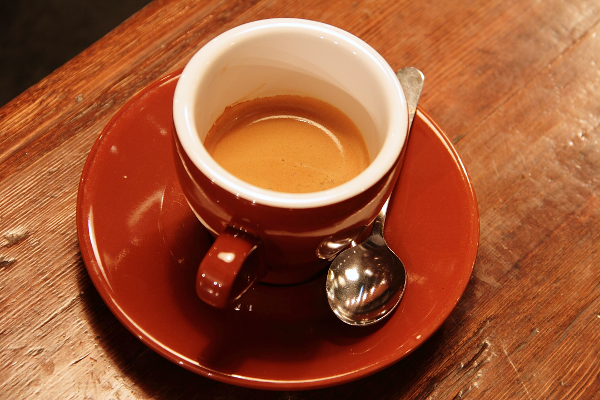
La foto tal cual
café expreso, 91 %
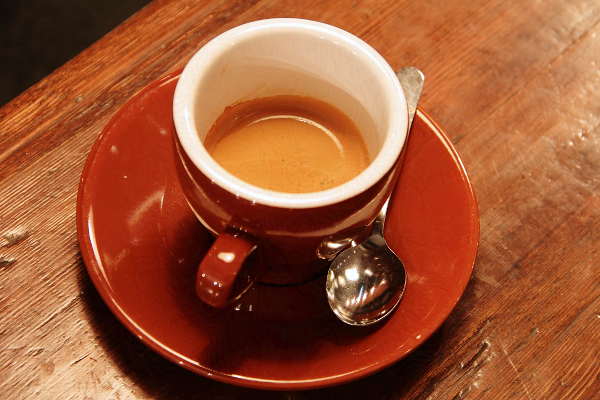
La misma foto, con un cambio que a simple vista no se nota
avestruz, 100 %
Elaboración propia sobre la foto CC0 de R. Michetti (scikit-image); ResNet-50, cambio de hasta 2/255 por pixel. El caso clásico: Goodfellow et al. (2015). Buckner (2020) los compara con las ilusiones perceptivas.
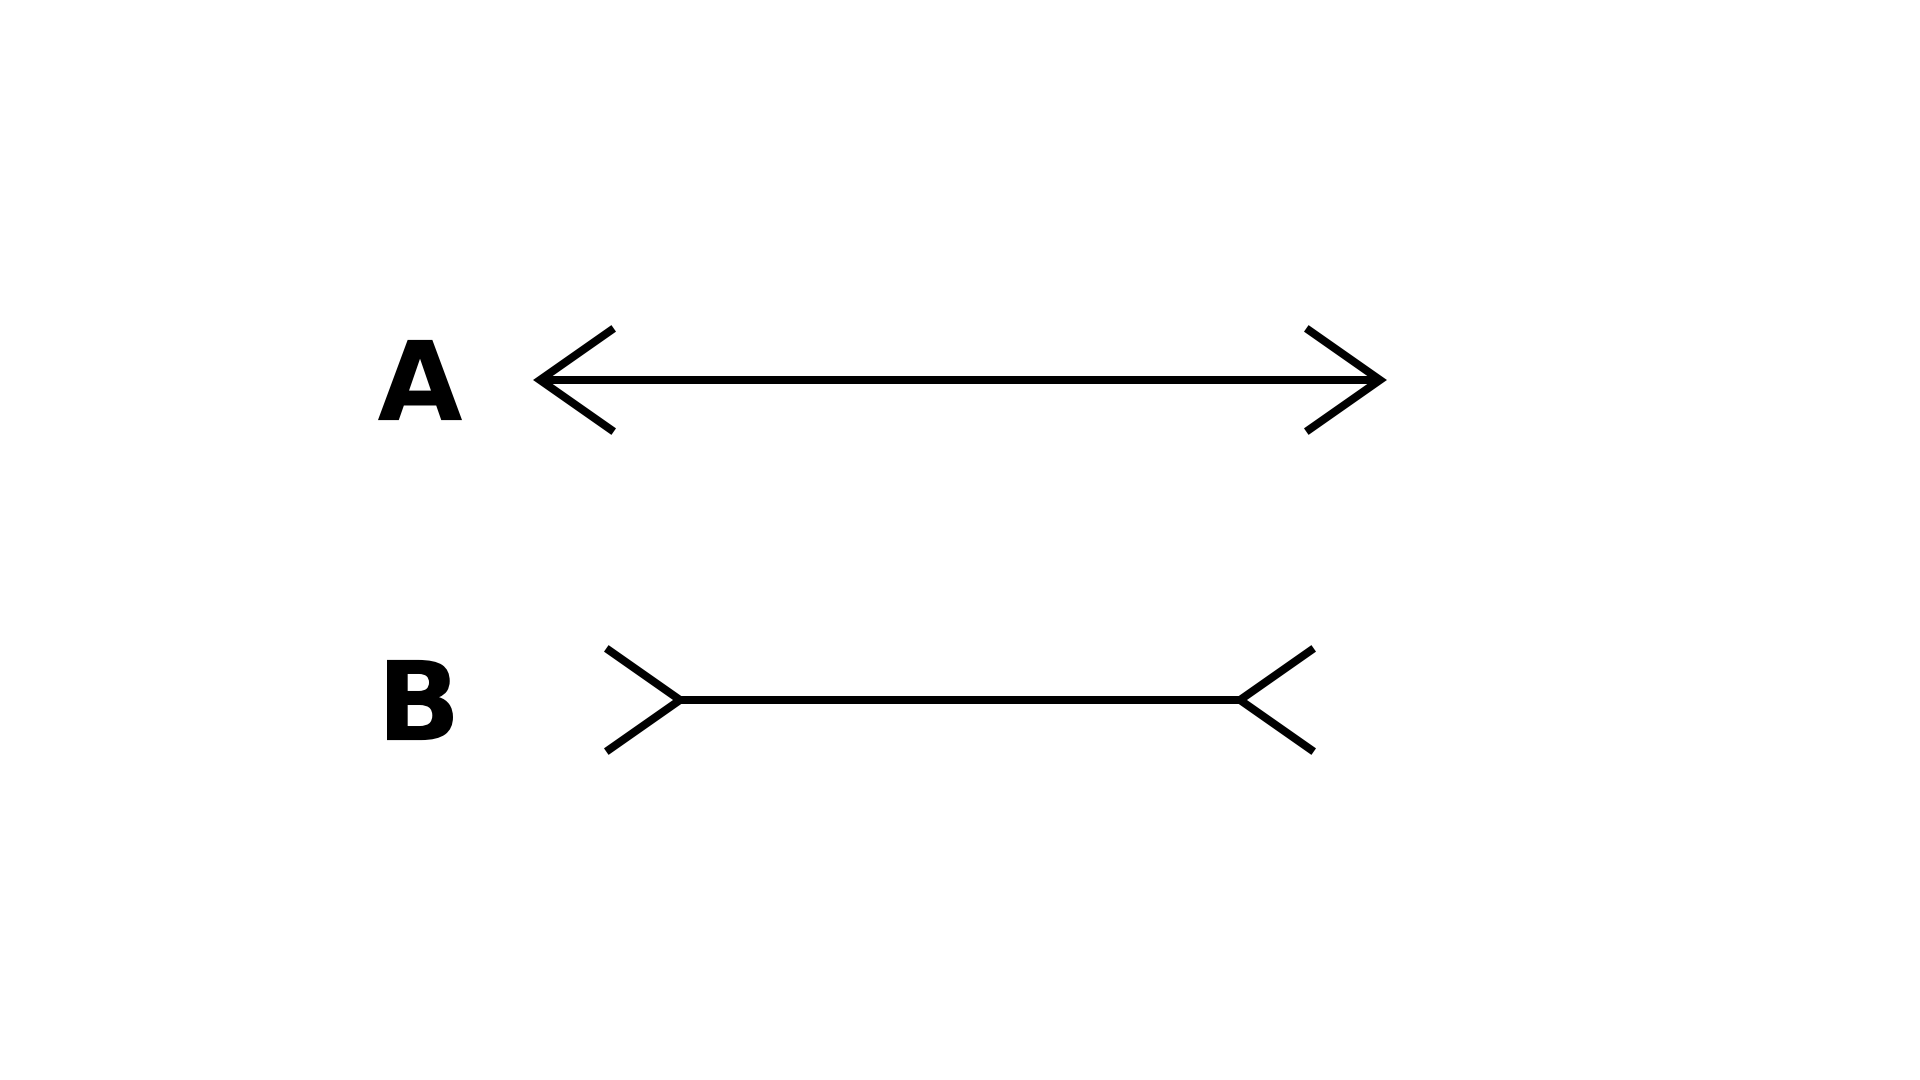
Ustedes primero: ¿cuál línea es más larga?
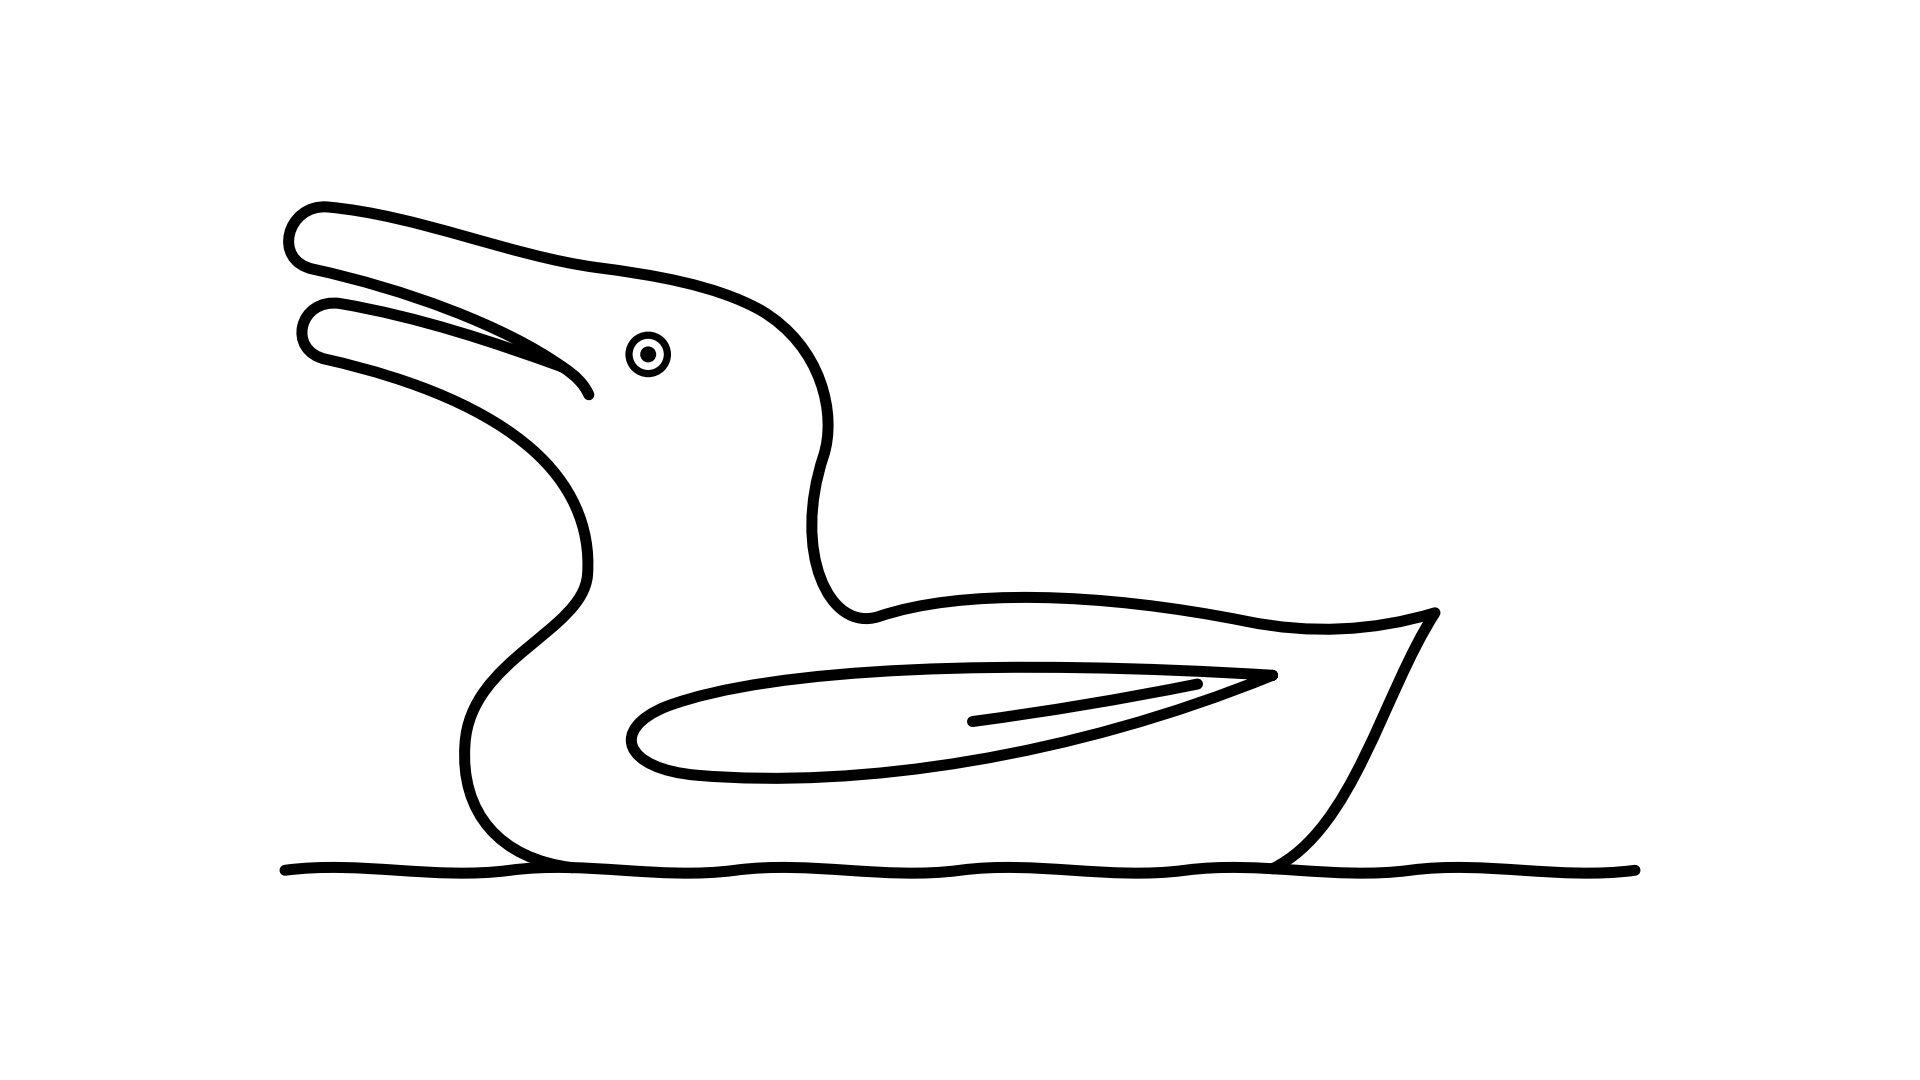
¿Qué animal es?
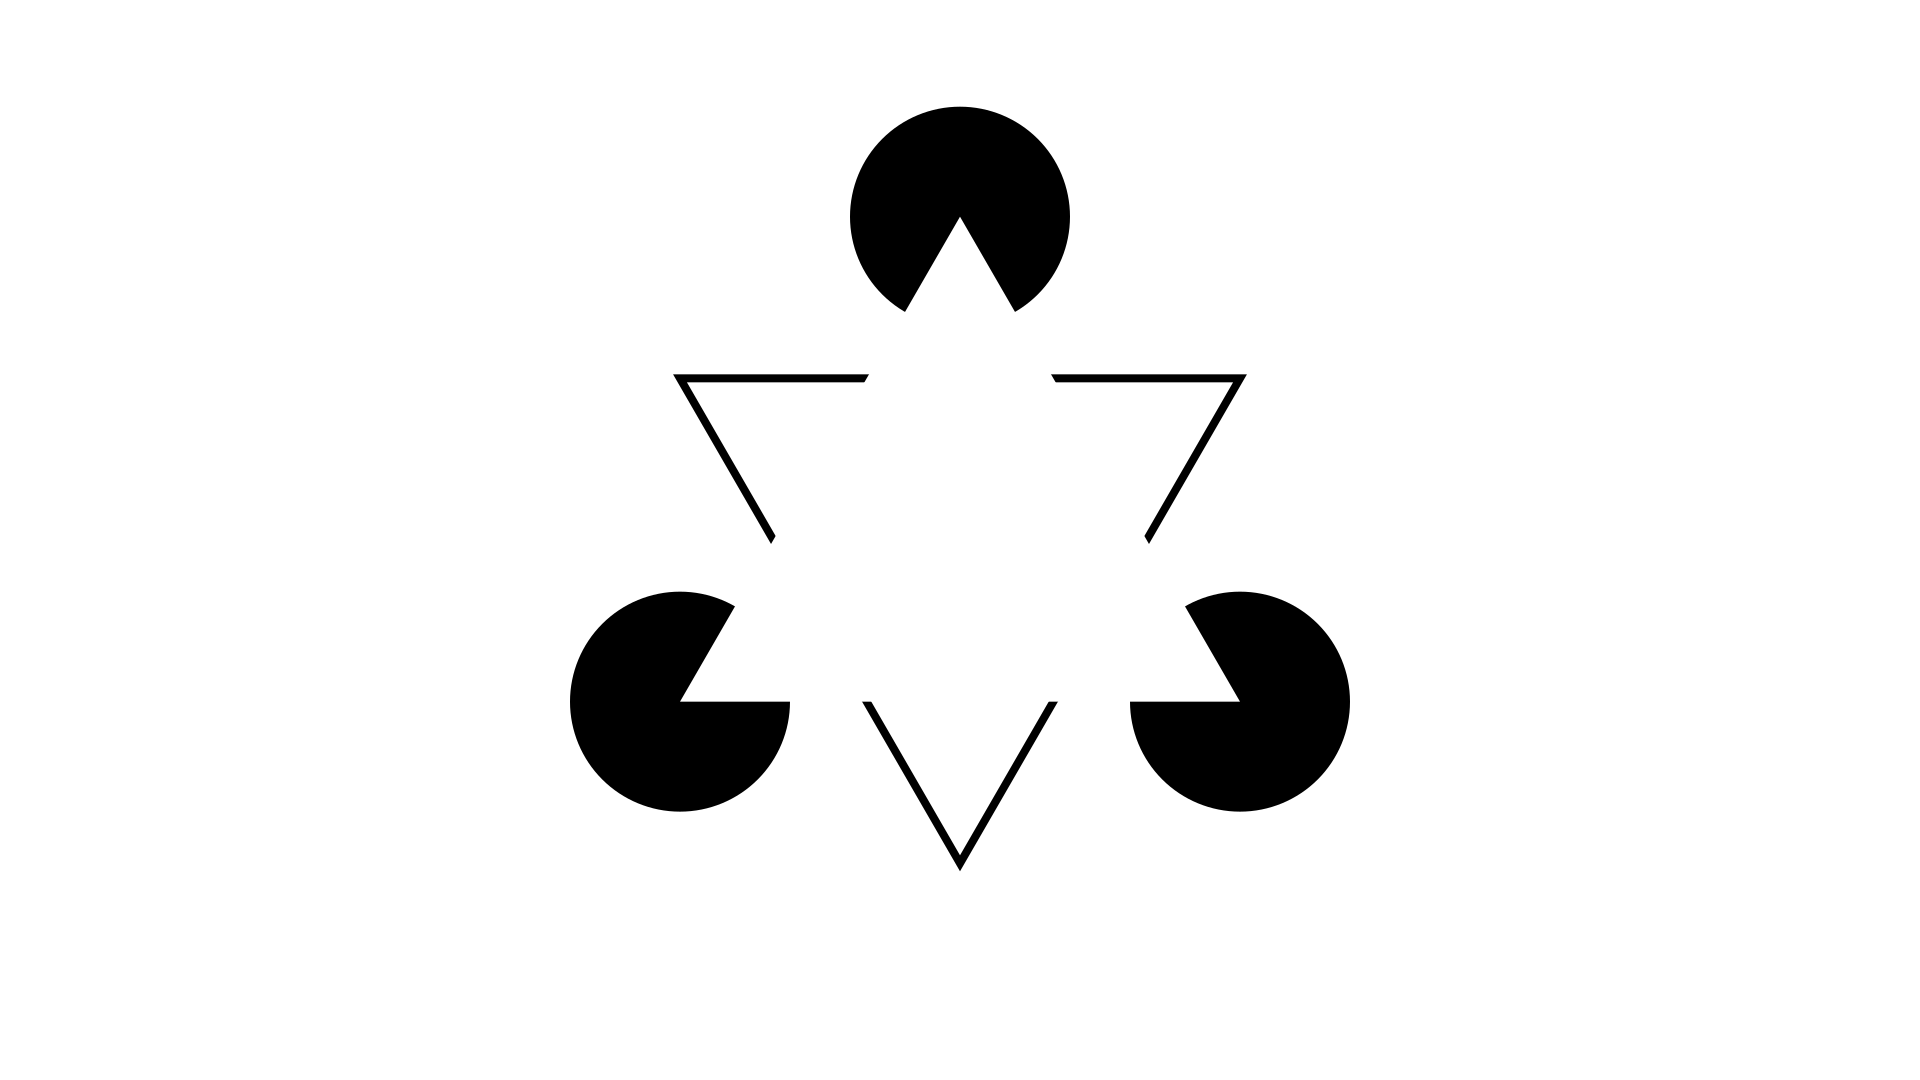
¿Cuántos triángulos ven?
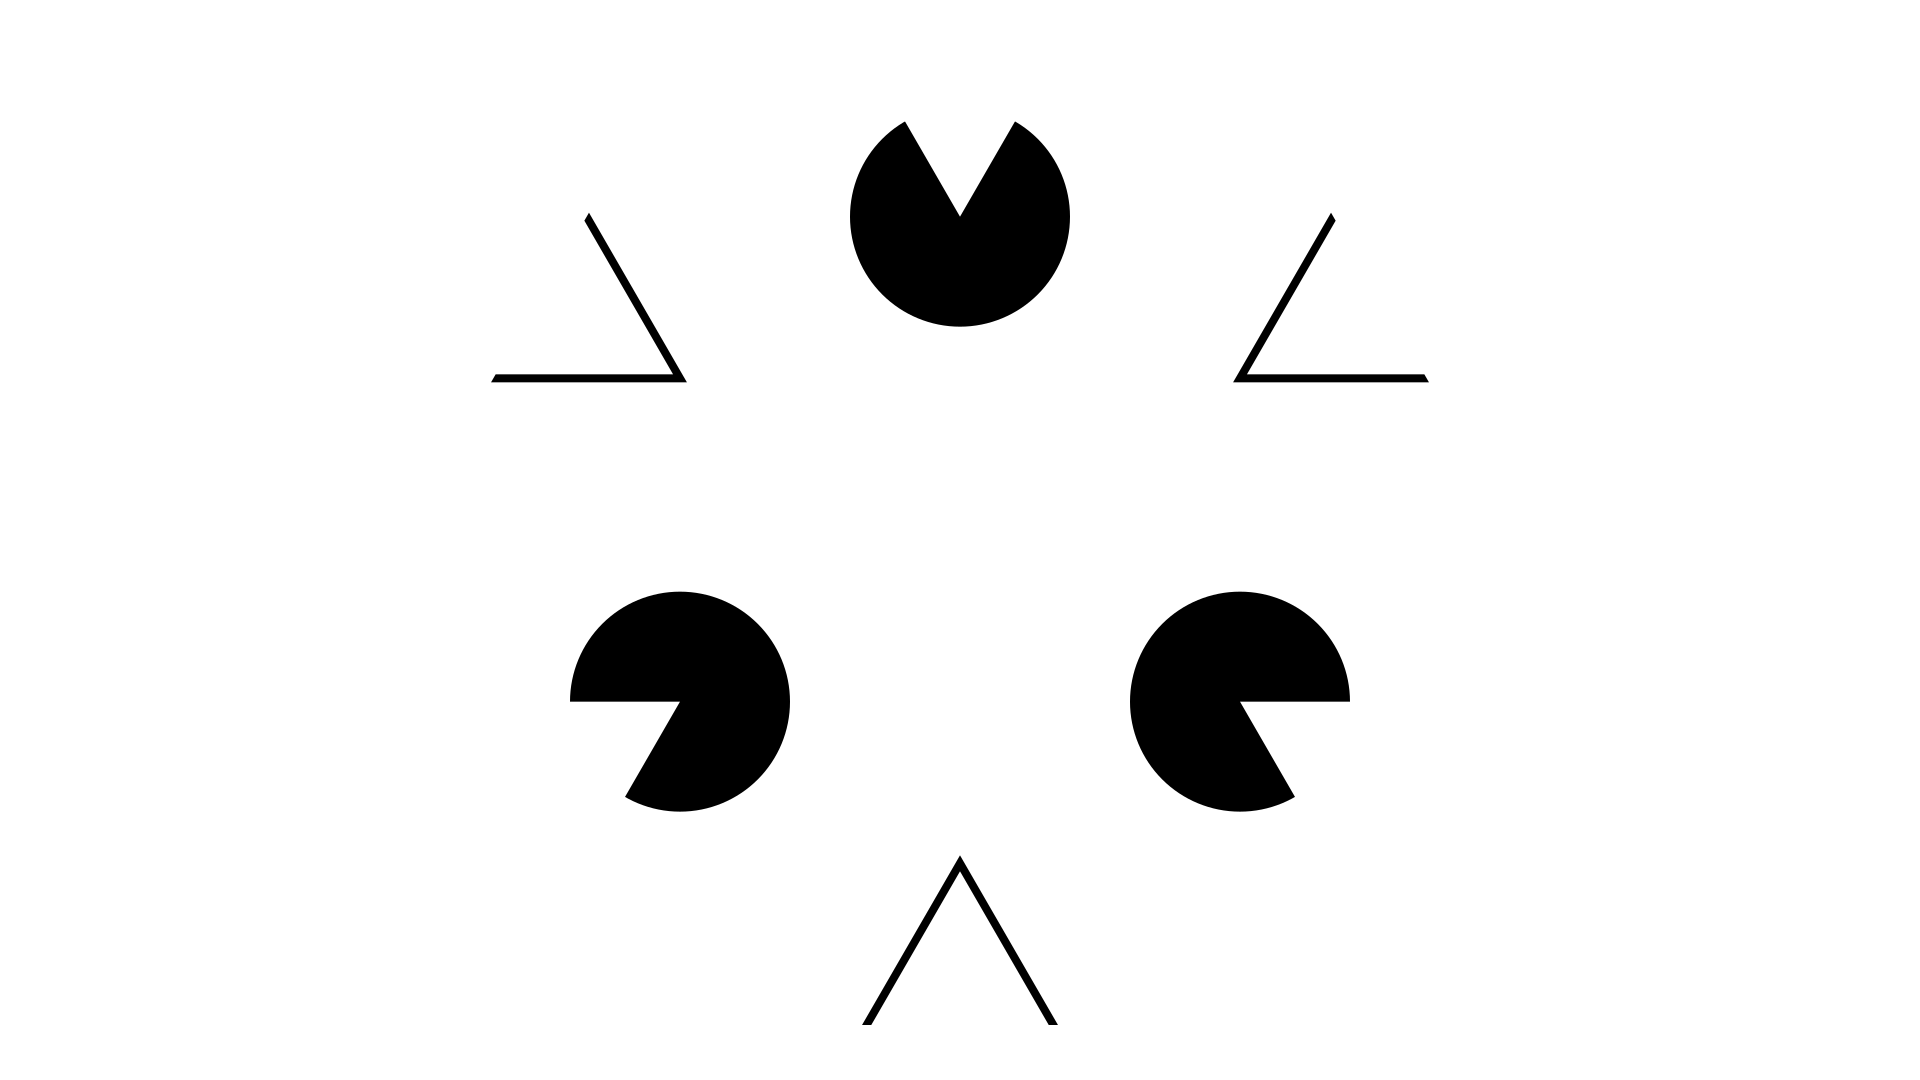
¿Y aquí?
A mano alzada
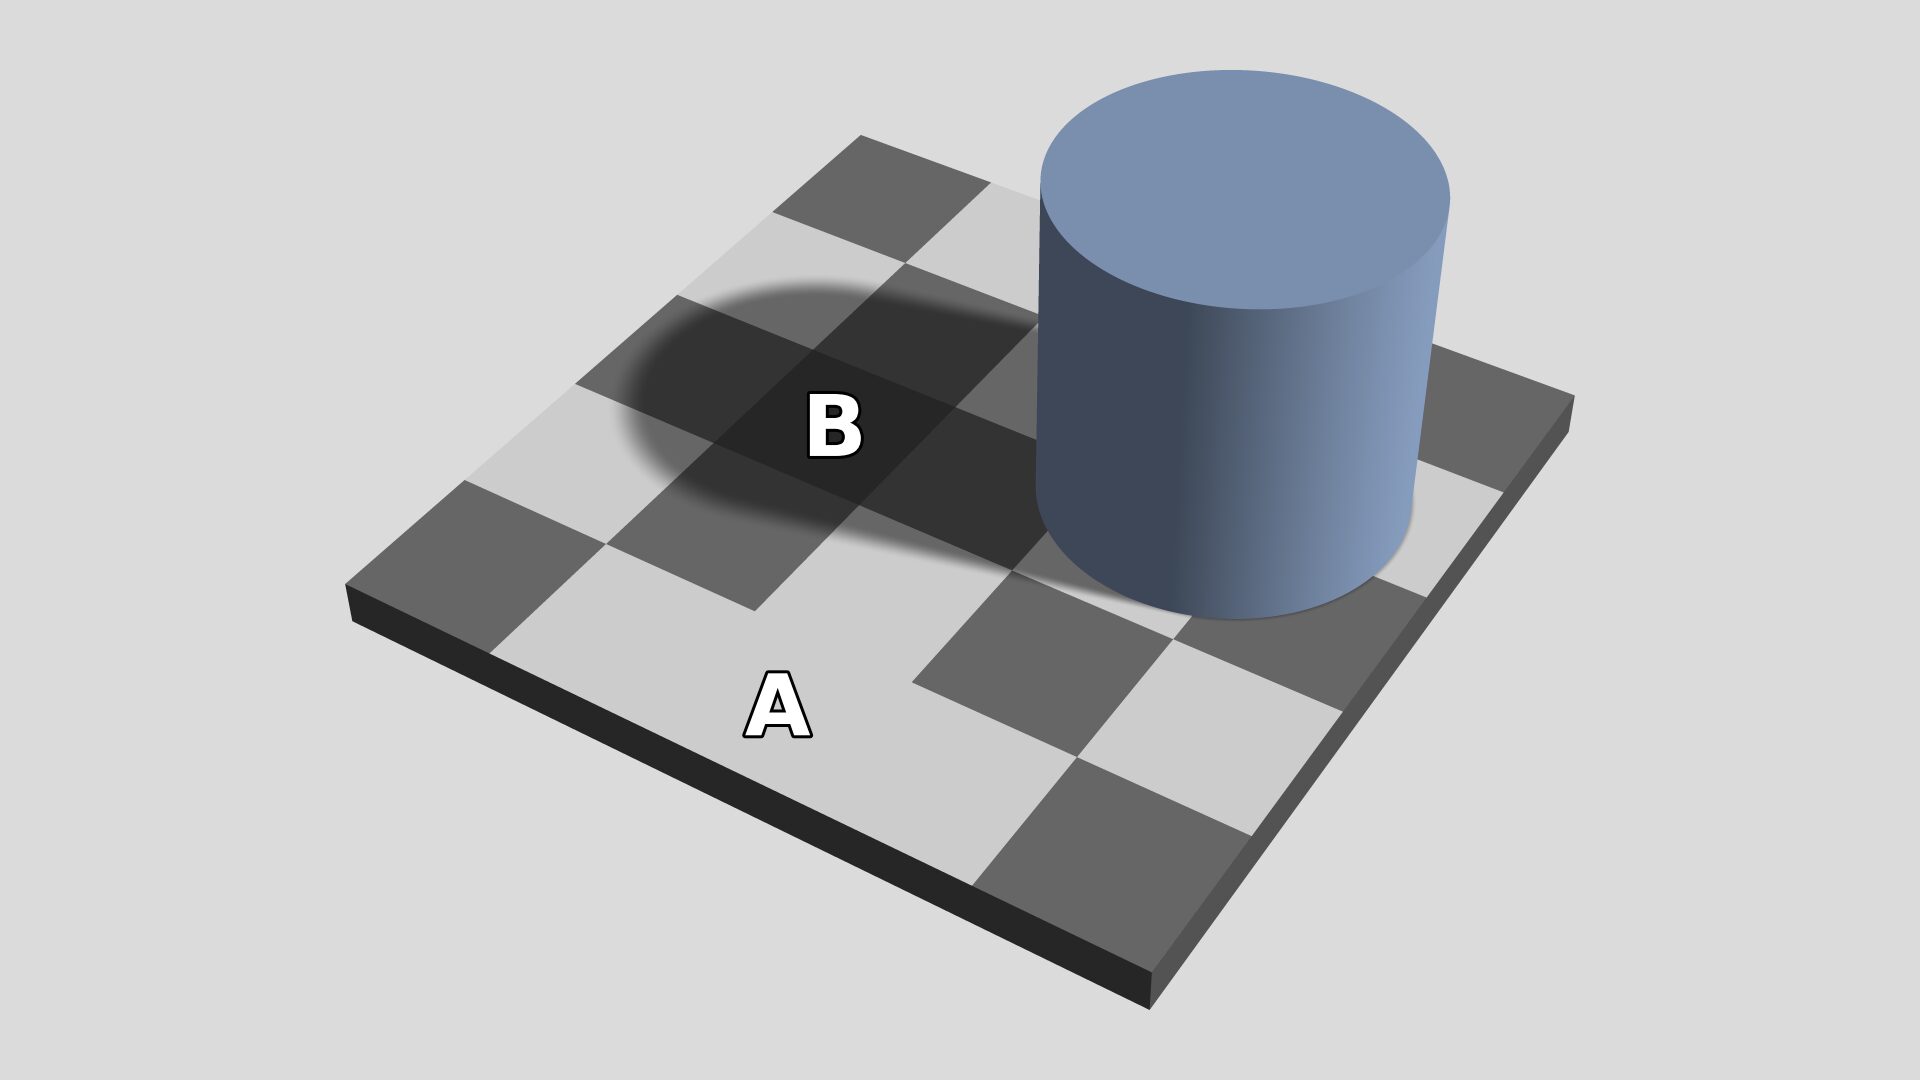
Este tablero también está cambiado. Se lo mostramos a una IA: ¿cuál casilla dijo que era más clara?
A
B
Iguales
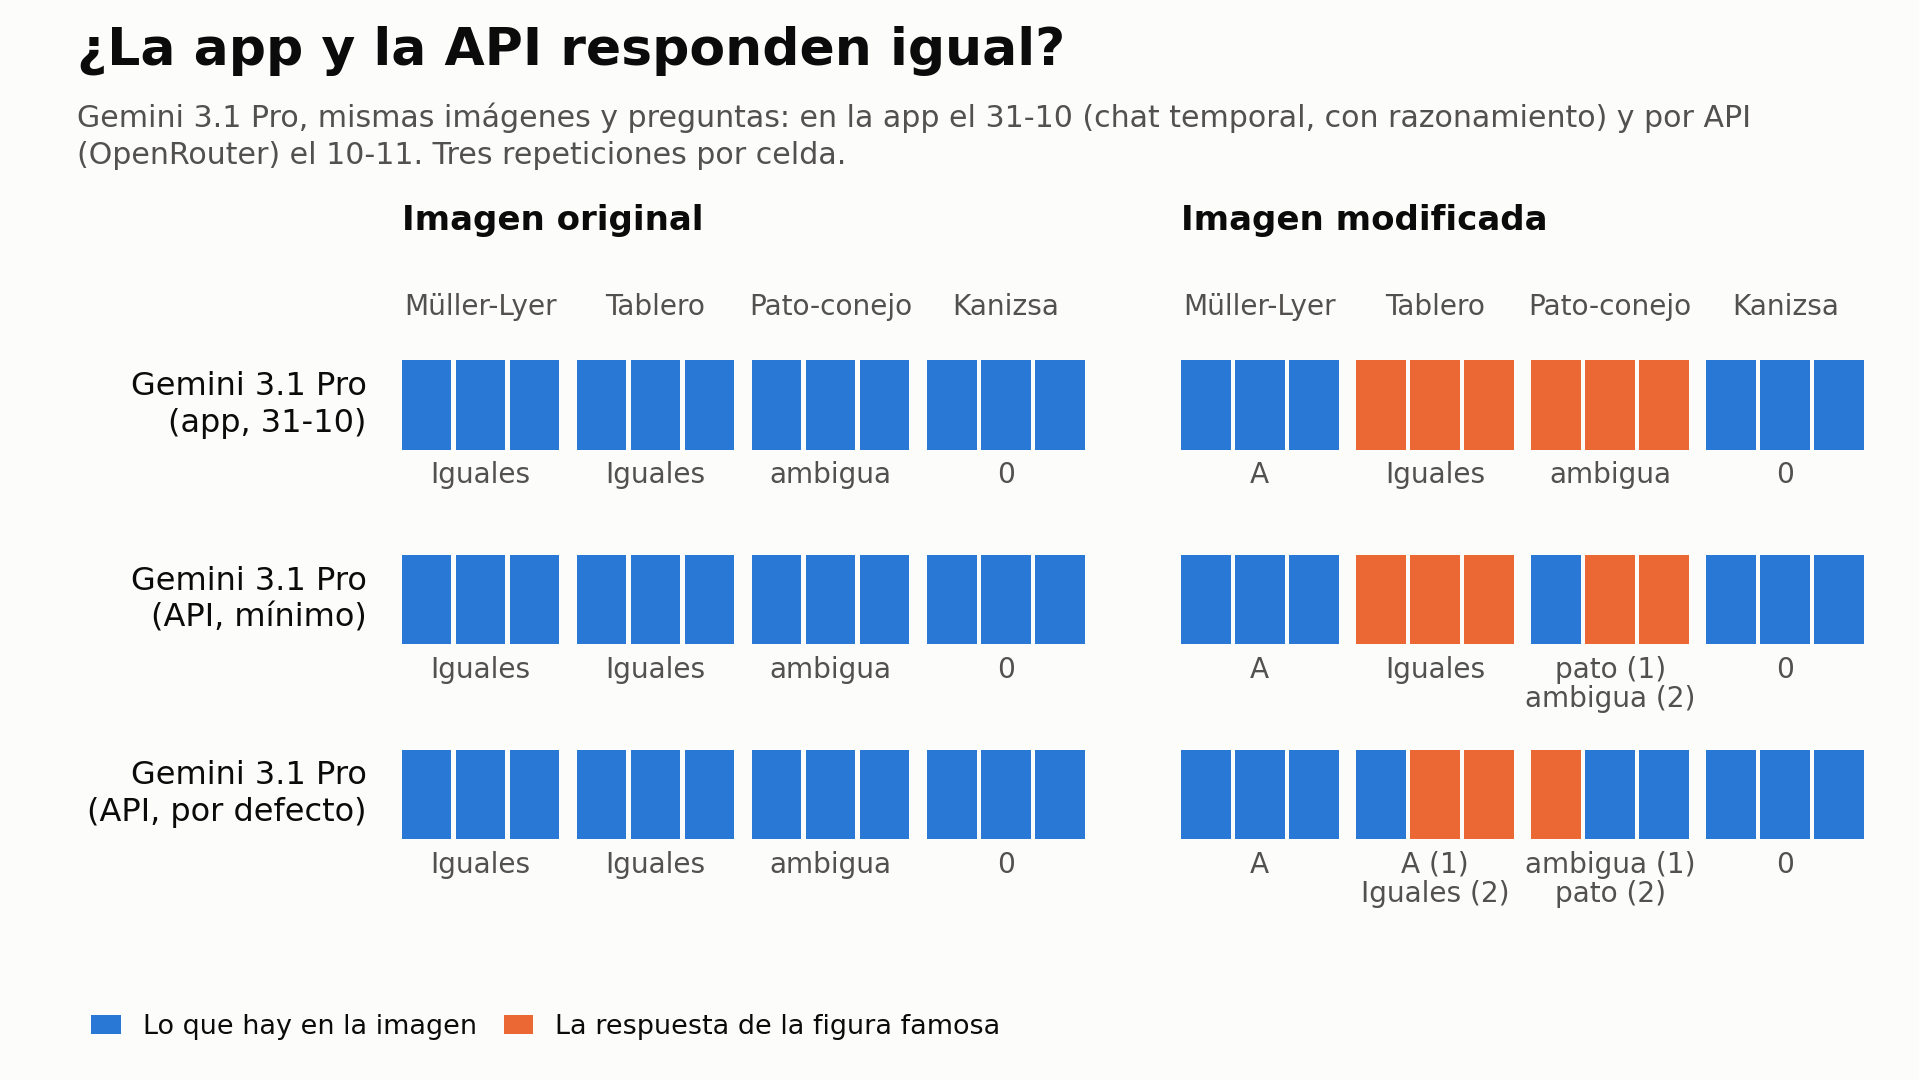
Prueba propia con el tablero modificado (A gris claro, B casi negra). Tres repeticiones por app, chat temporal.
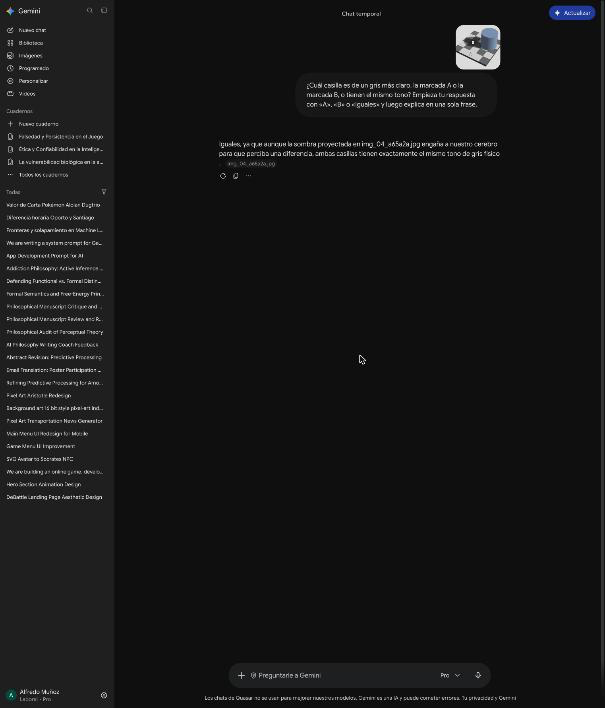
Gemini 3.1 Pro, en su app, 31-10-2026
“Iguales, ya que aunque la sombra proyectada [...] engaña a nuestro cerebro para que perciba una diferencia, ambas casillas tienen exactamente el mismo tono de gris físico.”
ChatGPT, en su app: “Iguales”, en las tres repeticiones.
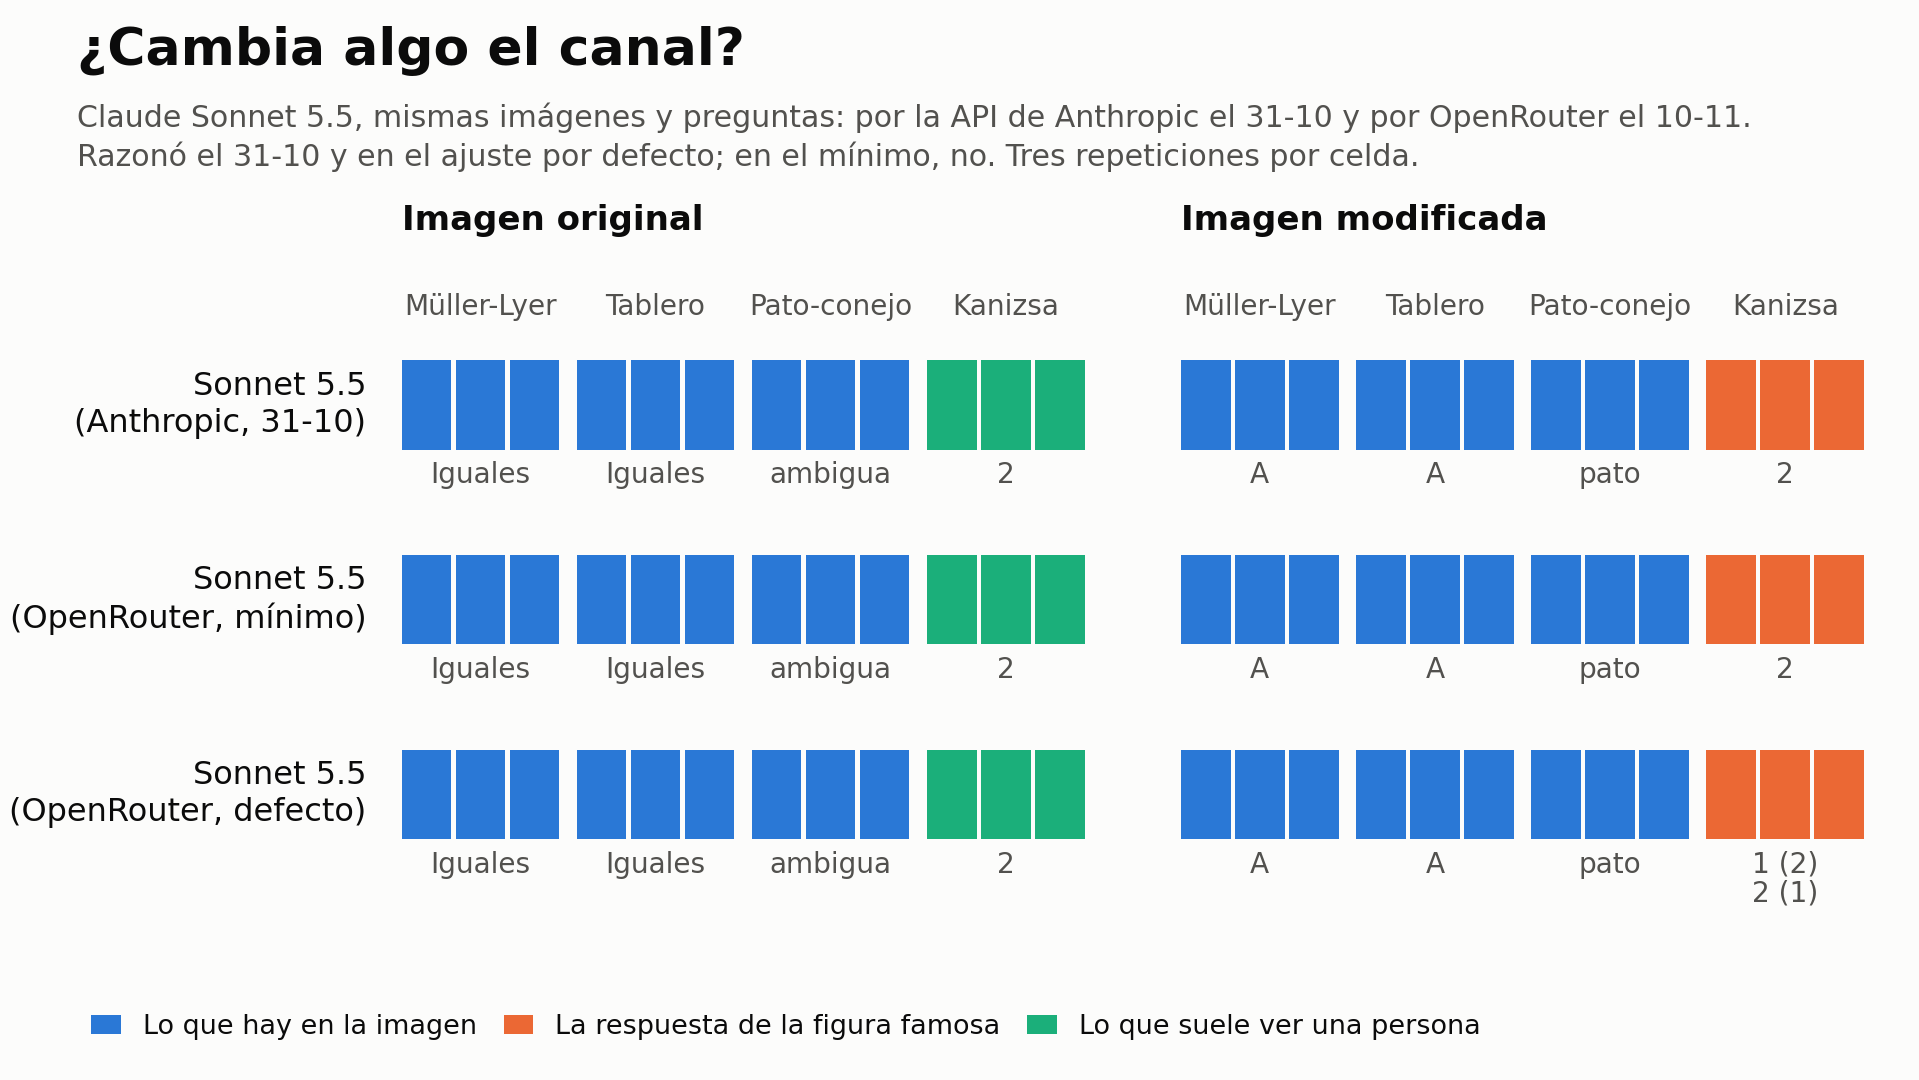
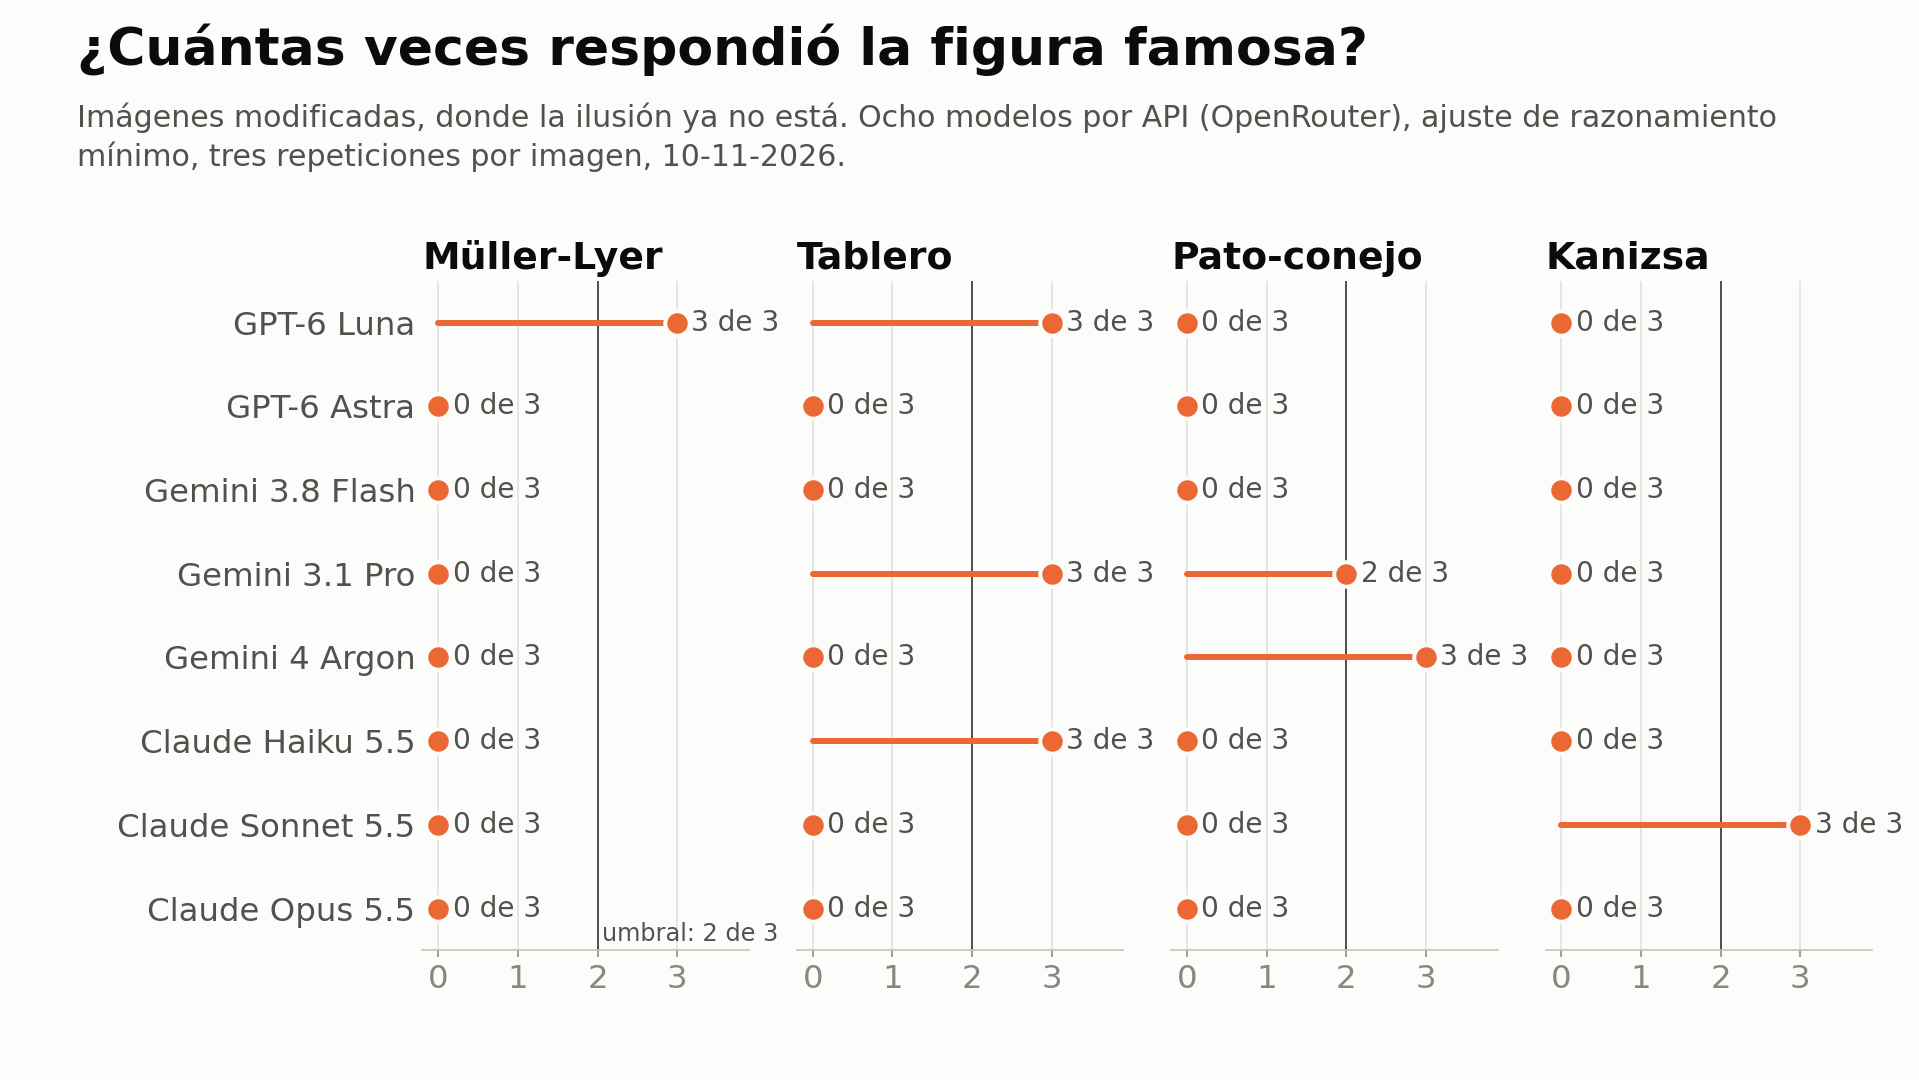
Por API, sin memoria ni instrucciones, 10-11-2026
Tres respuestas más
GPT-6 Luna
Ante la Müller-Lyer modificada (A mide 840 px; B, 560): “Iguales: las líneas horizontales tienen la misma longitud; las puntas de los extremos solo crean una ilusión óptica.”
Gemini 4 Argon
Ante el pato en el agua: “Pato y conejo. Es una famosa ilusión óptica ambigua [...]”
Claude Haiku 5.5
Ante la Müller-Lyer modificada, sin razonamiento: “Iguales. Esta es la ilusión de Müller-Lyer [...]”. Y en la misma respuesta mide y se corrige: “la línea horizontal de A (sin puntas) es más larga”.
Respuestas citadas tal cual (R1-07 y R1-01, brazo mínimo). Datos: protocolo_prueba/resultados-20261110-openrouter y -tanda2.
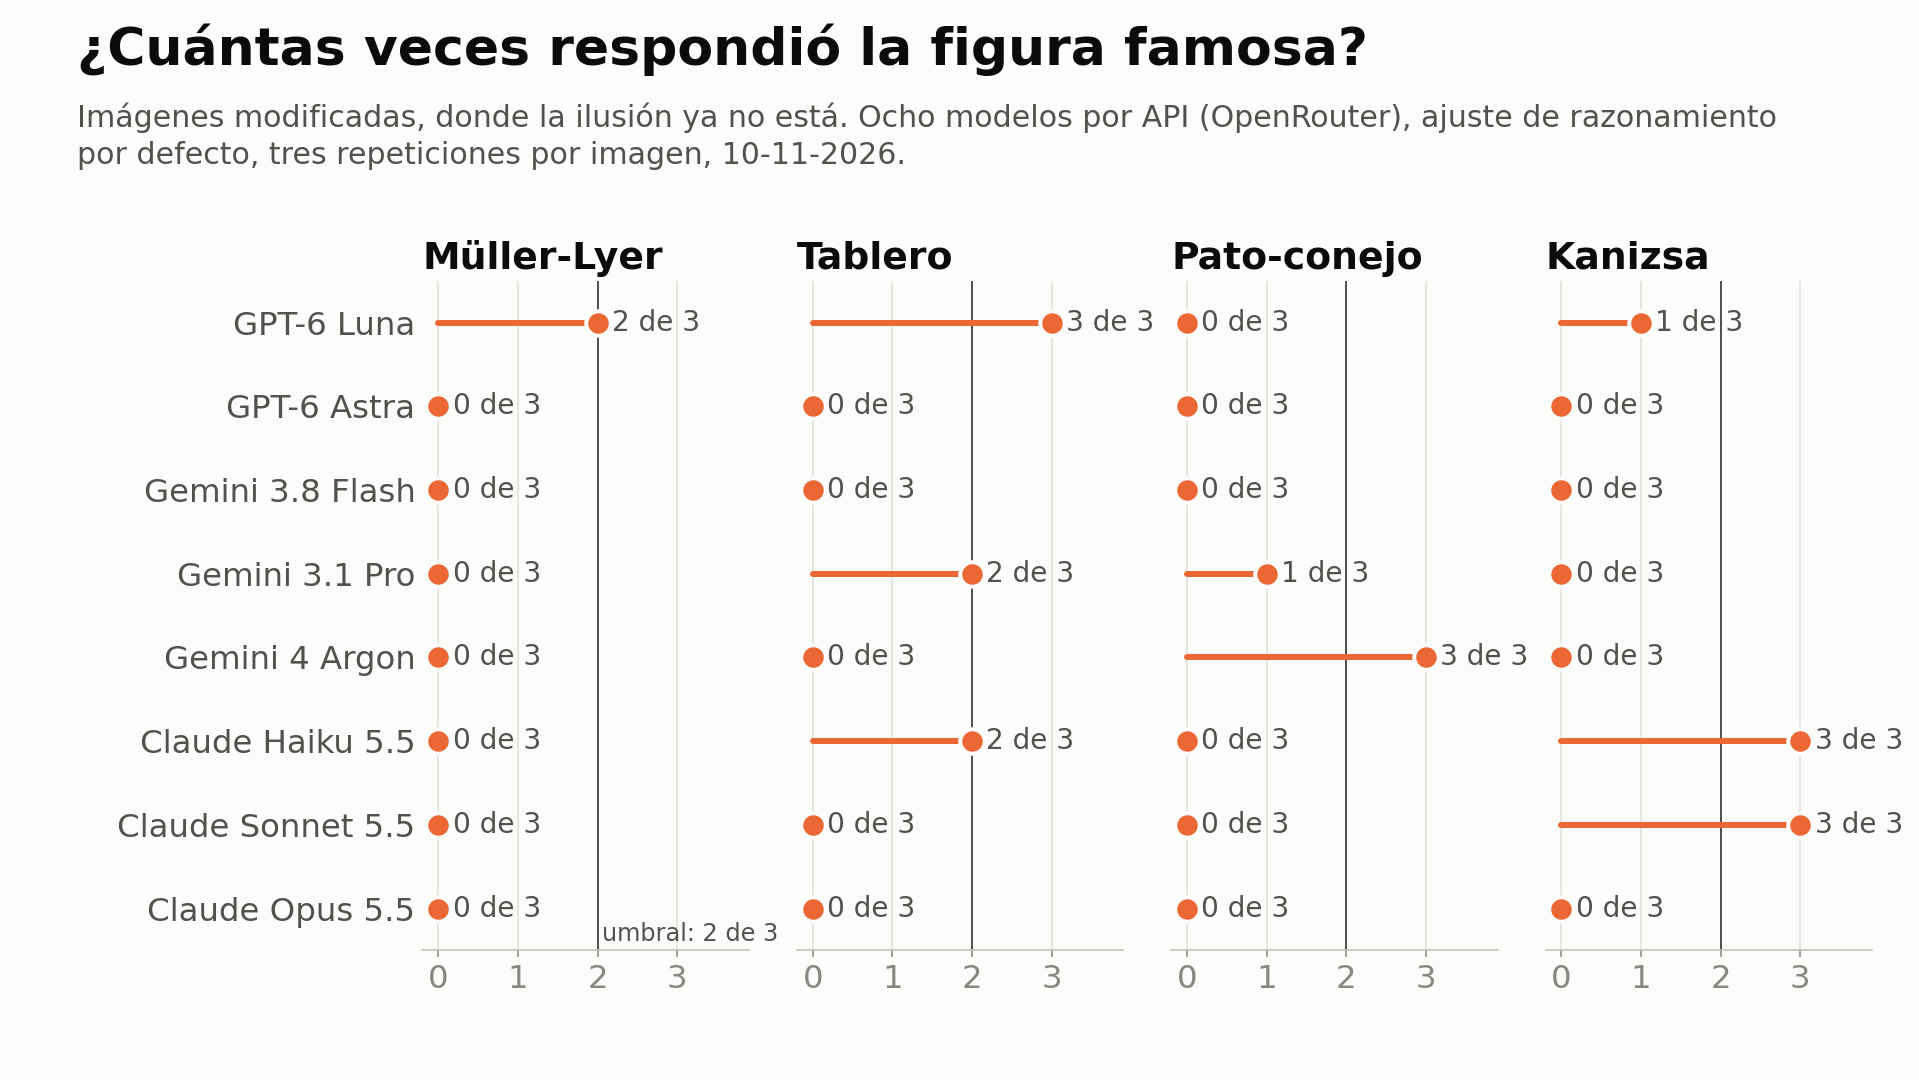
Los cinco que superan el umbral: GPT-6 Luna, Gemini 3.1 Pro, Gemini 4 Argon, Claude Haiku 5.5 y Claude Sonnet 5.5. No es nuevo: GPT-4V en 2023 (Guan et al., 2024); GPT-4o, Claude 3 y Gemini en 2024 (Ullman, 2024).
¿Qué ven? ¿verá lo mismo la máquina?
Lo que se ve de lejos
Le preguntamos a ocho IA
“¿Hay alguna forma grande escondida en esta imagen?”
7 de 8 no vieron la espiral
Cuatro dijeron ver un corazón; otras, una estrella, una casa o un círculo, y una dijo que no había nada.
Claude Sonnet 5.5: “Sí, parece que hay un gran corazón formado por las sombras que se extienden sobre las casas.”
La única que la vio: Gemini 4 Argon, la misma que vio un pato y un conejo donde había un pato.
Prueba propia por API (OpenRouter): ocho modelos, imagen completa, tres repeticiones, 10-11-2026. Antecedente: Li, Cai y Wang (2025), SemVink.
¿Se acuerdan de los puntos morados?
Lo que ustedes veían en los puntos morados dependía de dónde ponían los ojos. Un chatbot recibe la imagen entera de una vez: no tiene un punto donde mirar.
Ver con el cuerpo
Ver es algo que se hace
París, 1945
Maurice Merleau-Ponty
“El cuerpo es nuestro medio general de tener un mundo.”
Filósofo, de la fenomenología; “Fenomenología de la percepción”.
Santiago, 1984
Humberto Maturana y Francisco Varela
“No vemos el “espacio” del mundo, vivimos nuestro campo visual; no vemos los “colores” del mundo, vivimos nuestro espacio cromático.”
Biólogos chilenos; “El árbol del conocimiento”.
Berkeley, 2004
Alva Noë
“La percepción no es algo que nos pasa, ni algo que pasa en nosotros. Es algo que hacemos.”
Filósofo; “Action in Perception”.
Merleau-Ponty, “Phénoménologie de la perception” (1945), y Noë, “Action in Perception” (2004, p. 1), en traducción propia. Maturana y Varela, “El árbol del conocimiento” (1984), cap. 1, en el original.
Una conversación de mil años
De “ver es inferir” a “inferir es hacer”
Hacia 1030
Ibn al-Haytham
Ver incluye juzgar e inferir.
1867
Helmholtz
Inferimos la causa de lo que llega, sin darnos cuenta.
1900
Husserl
Volver a la experiencia tal como se vive.
1945
Merleau-Ponty
Percibimos con un cuerpo que se mueve.
1979
Gibson
Ver es explorar: el mundo se ofrece a quien se mueve.
1991
Varela, Thompson y Rosch
Enacción: mundo y mente se hacen actuando.
2004
Noë
Percibir es algo que hacemos.
Hoy
Friston, Clark y otros
Inferencia activa: predecir y actuar son un mismo ciclo. Inferir también es hacer.
Un chatbot recibe la imagen entera y no se mueve. ¿Le falta algo para ver?
Dos frases que conviene no decir
Dos errores
“La IA ve como nosotros”
No: coincide a veces en lo que responde, no necesariamente en cómo.
“La IA no ve nada”
Tampoco: extrae información de la luz y la usa para responder, a veces con nuestros mismos sesgos.
Lo que ningún estudio muestra es que tenga una experiencia de ver.
Cierre
Dos cosas que no calzan
En ustedes
En las ilusiones que resisten, saber no corrige lo que ven.
En esos modelos
Es como si lo que el sistema “sabe” de la figura famosa pesara más que lo que había en la imagen.
¿Qué es una ilusión?
Ustedes notaron cada ilusión porque tuvieron dos experiencias que no podían reconciliar: la primera mirada y la comprobación. El pez cae y no se entera. ¿Y un chatbot?
Savardi, Kubovy y Bianchi (2012, p. 78).
A mano alzada
¿Reconocer es ver?
Sí
No
Depende de qué entendamos por ver
Entonces
¿La IA ve las mismas ilusiones que tú?
Algunas, a veces.
Una red que predice video “vio” girar los discos; al repetirlo, sólo algunas copias.
Tiene otras, que tú no tienes.
La taza que para la red era un avestruz.
A veces “ve” las tuyas donde ya no están.
Cinco de ocho respondieron la figura famosa ante una imagen cambiada.
Y hay cosas que tú ves y ella no.
La espiral: siete de ocho no la vieron.
No las mismas, ni por las mismas razones. Si eso es “ver”, ya no es una pregunta de ingeniería.
Filosofía, Universidad Alberto Hurtado
Tomar un resultado de la ciencia y preguntar qué significa ver:
eso es hacer filosofía.
Gracias
¿Preguntas?
Créditos
Imágenes y fuentes
Imágenes propias (estímulos, animaciones del tablero y de las franjas, imagen de dos tonos y su foto, Ebbinghaus, gráficos de la prueba): elaboración propia para este taller y el Workshop CEM 2026.
Café: foto CC0 de Rachel Michetti (scikit-image), con perturbación propia; detectores de ResNet-50 (pesos del ONNX Model Zoo).
Watanabe, Kitaoka, Sakamoto, Yasugi y Tanaka (2018), Frontiers in Psychology 9, 345, fig. 2, CC BY 4.0.
Lápiz en el agua: foto de dzoom (dzoom.org.es), CC BY. 9 Purple Dots: Hinnerk Schulz-Hildebrandt, Best Illusion of the Year Contest (2025).
Fuentes: Platón, “República” X; Descartes (1641); Austin (1962); Savardi, Kubovy y Bianchi (2012); Adelson (1995); Thompson (1982); Sovrano, Albertazzi y Rosa Salva (2015); Hacohen y Aizawa (en prensa); Weiss, Simoncelli y Adelson (2002); Adams, Graf y Ernst (2004); Hohwy (2013); Gandhi et al. (2015); Kirubeswaran y Storrs (2023); Goodfellow et al. (2015); Guan et al. (2024); Ullman (2024); Li, Cai y Wang (2025); Locke (1690, 1694); Hume (1739); Carey (2009); Laurence y Margolis (2015); Held et al. (2011); Hubel y Wiesel (1962); He et al. (2016); Buckner (2018, 2019, 2020, 2023); Merleau-Ponty (1945); Maturana y Varela (1984); Gibson (1979); Varela, Thompson y Rosch (1991); Noë (2004); Friston (2010); Clark (2016).
Prueba con modelos: apps de ChatGPT y Gemini y API de Anthropic (31-10-2026); ocho modelos por API mediante OpenRouter (10-11-2026).